Probability Distributions
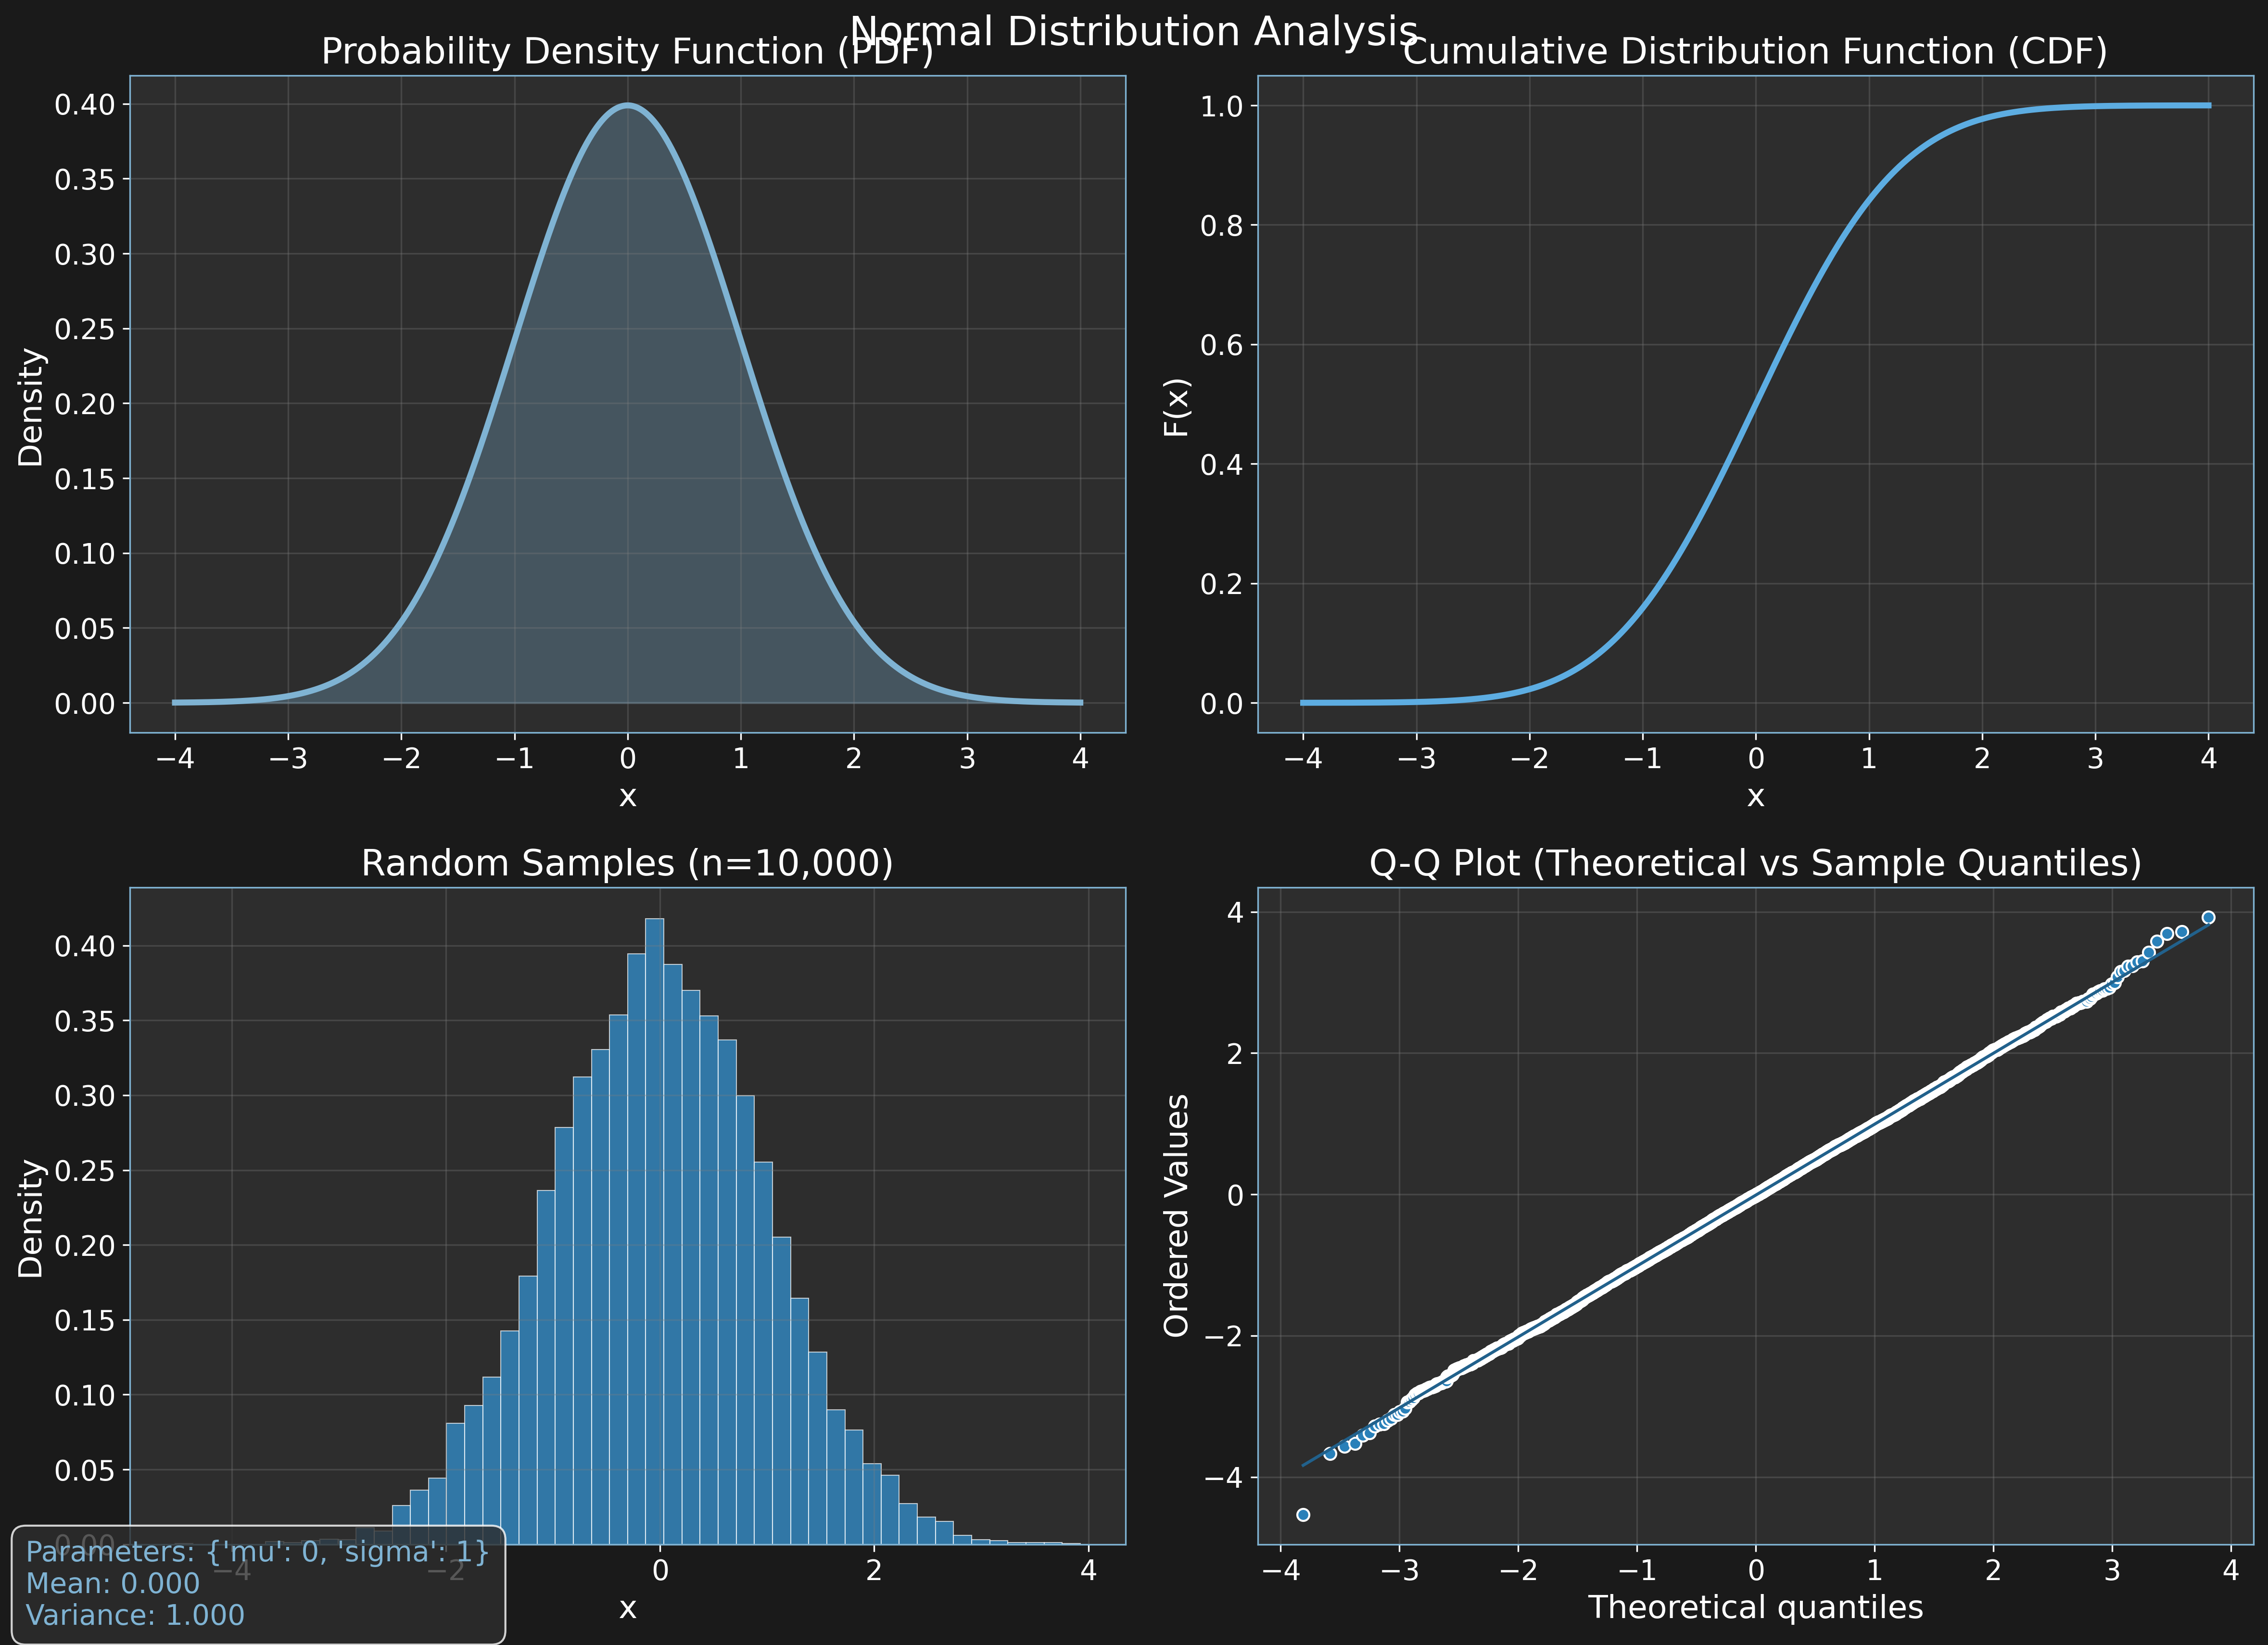
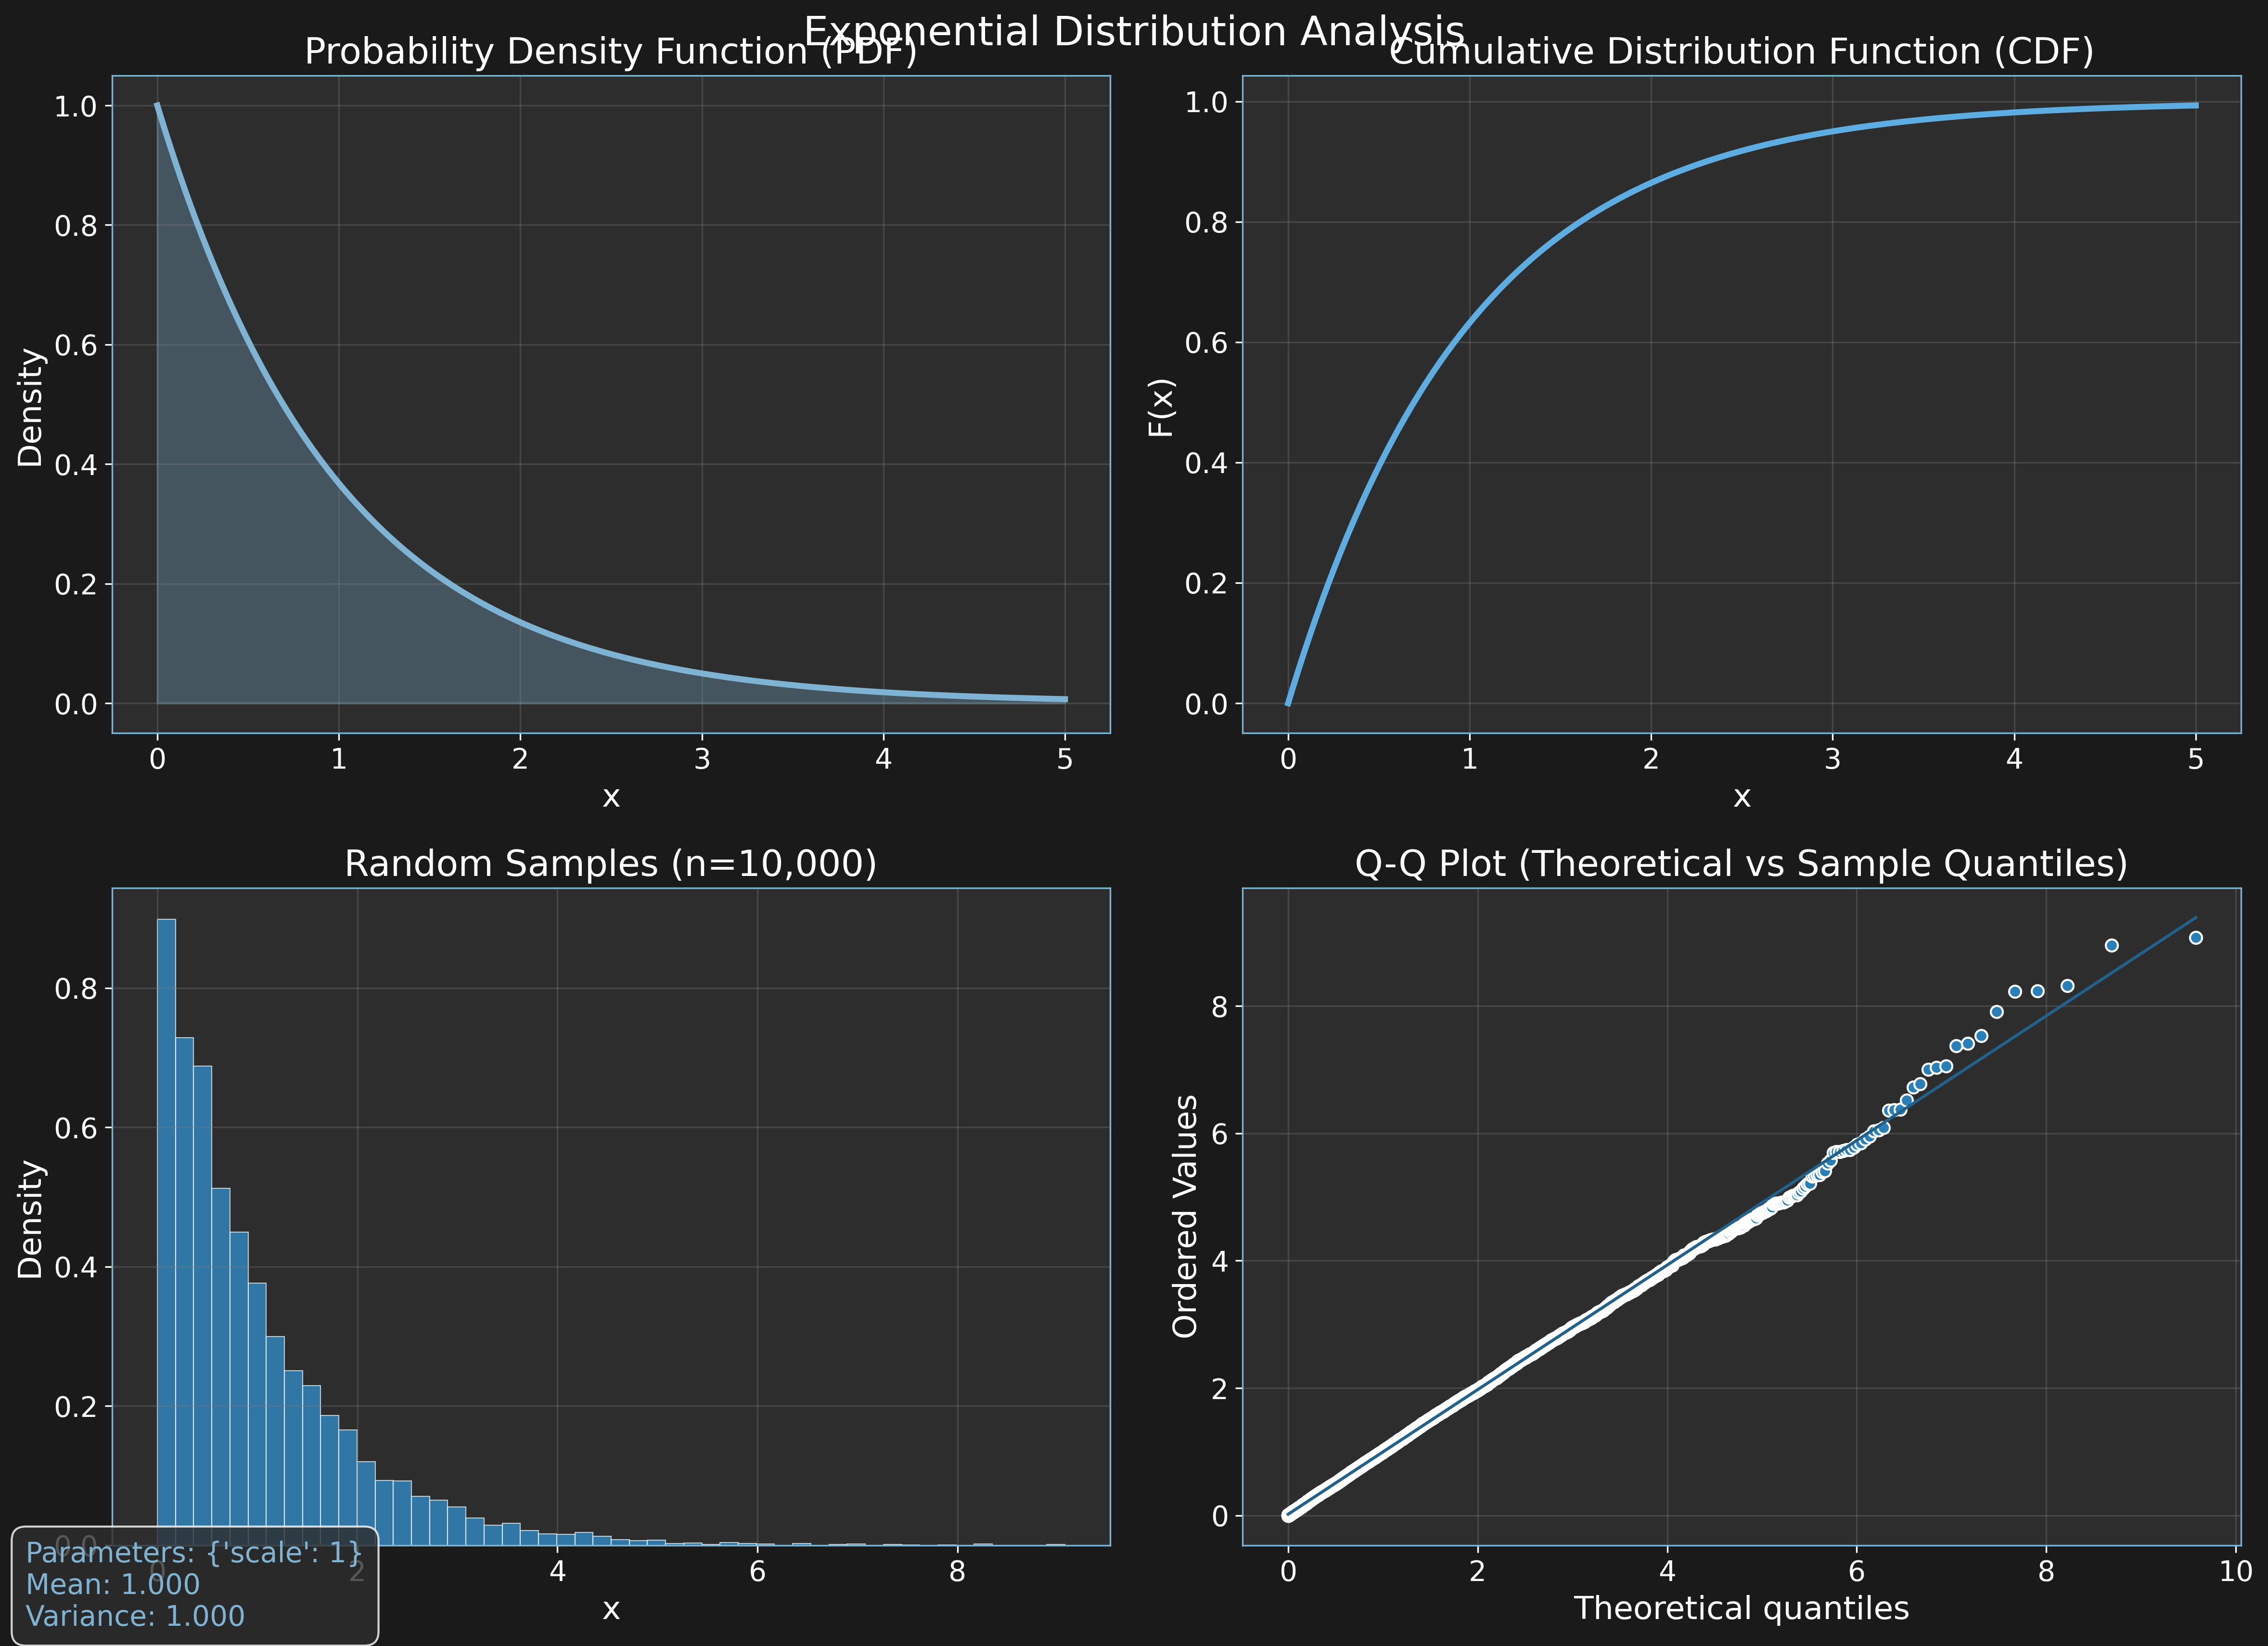
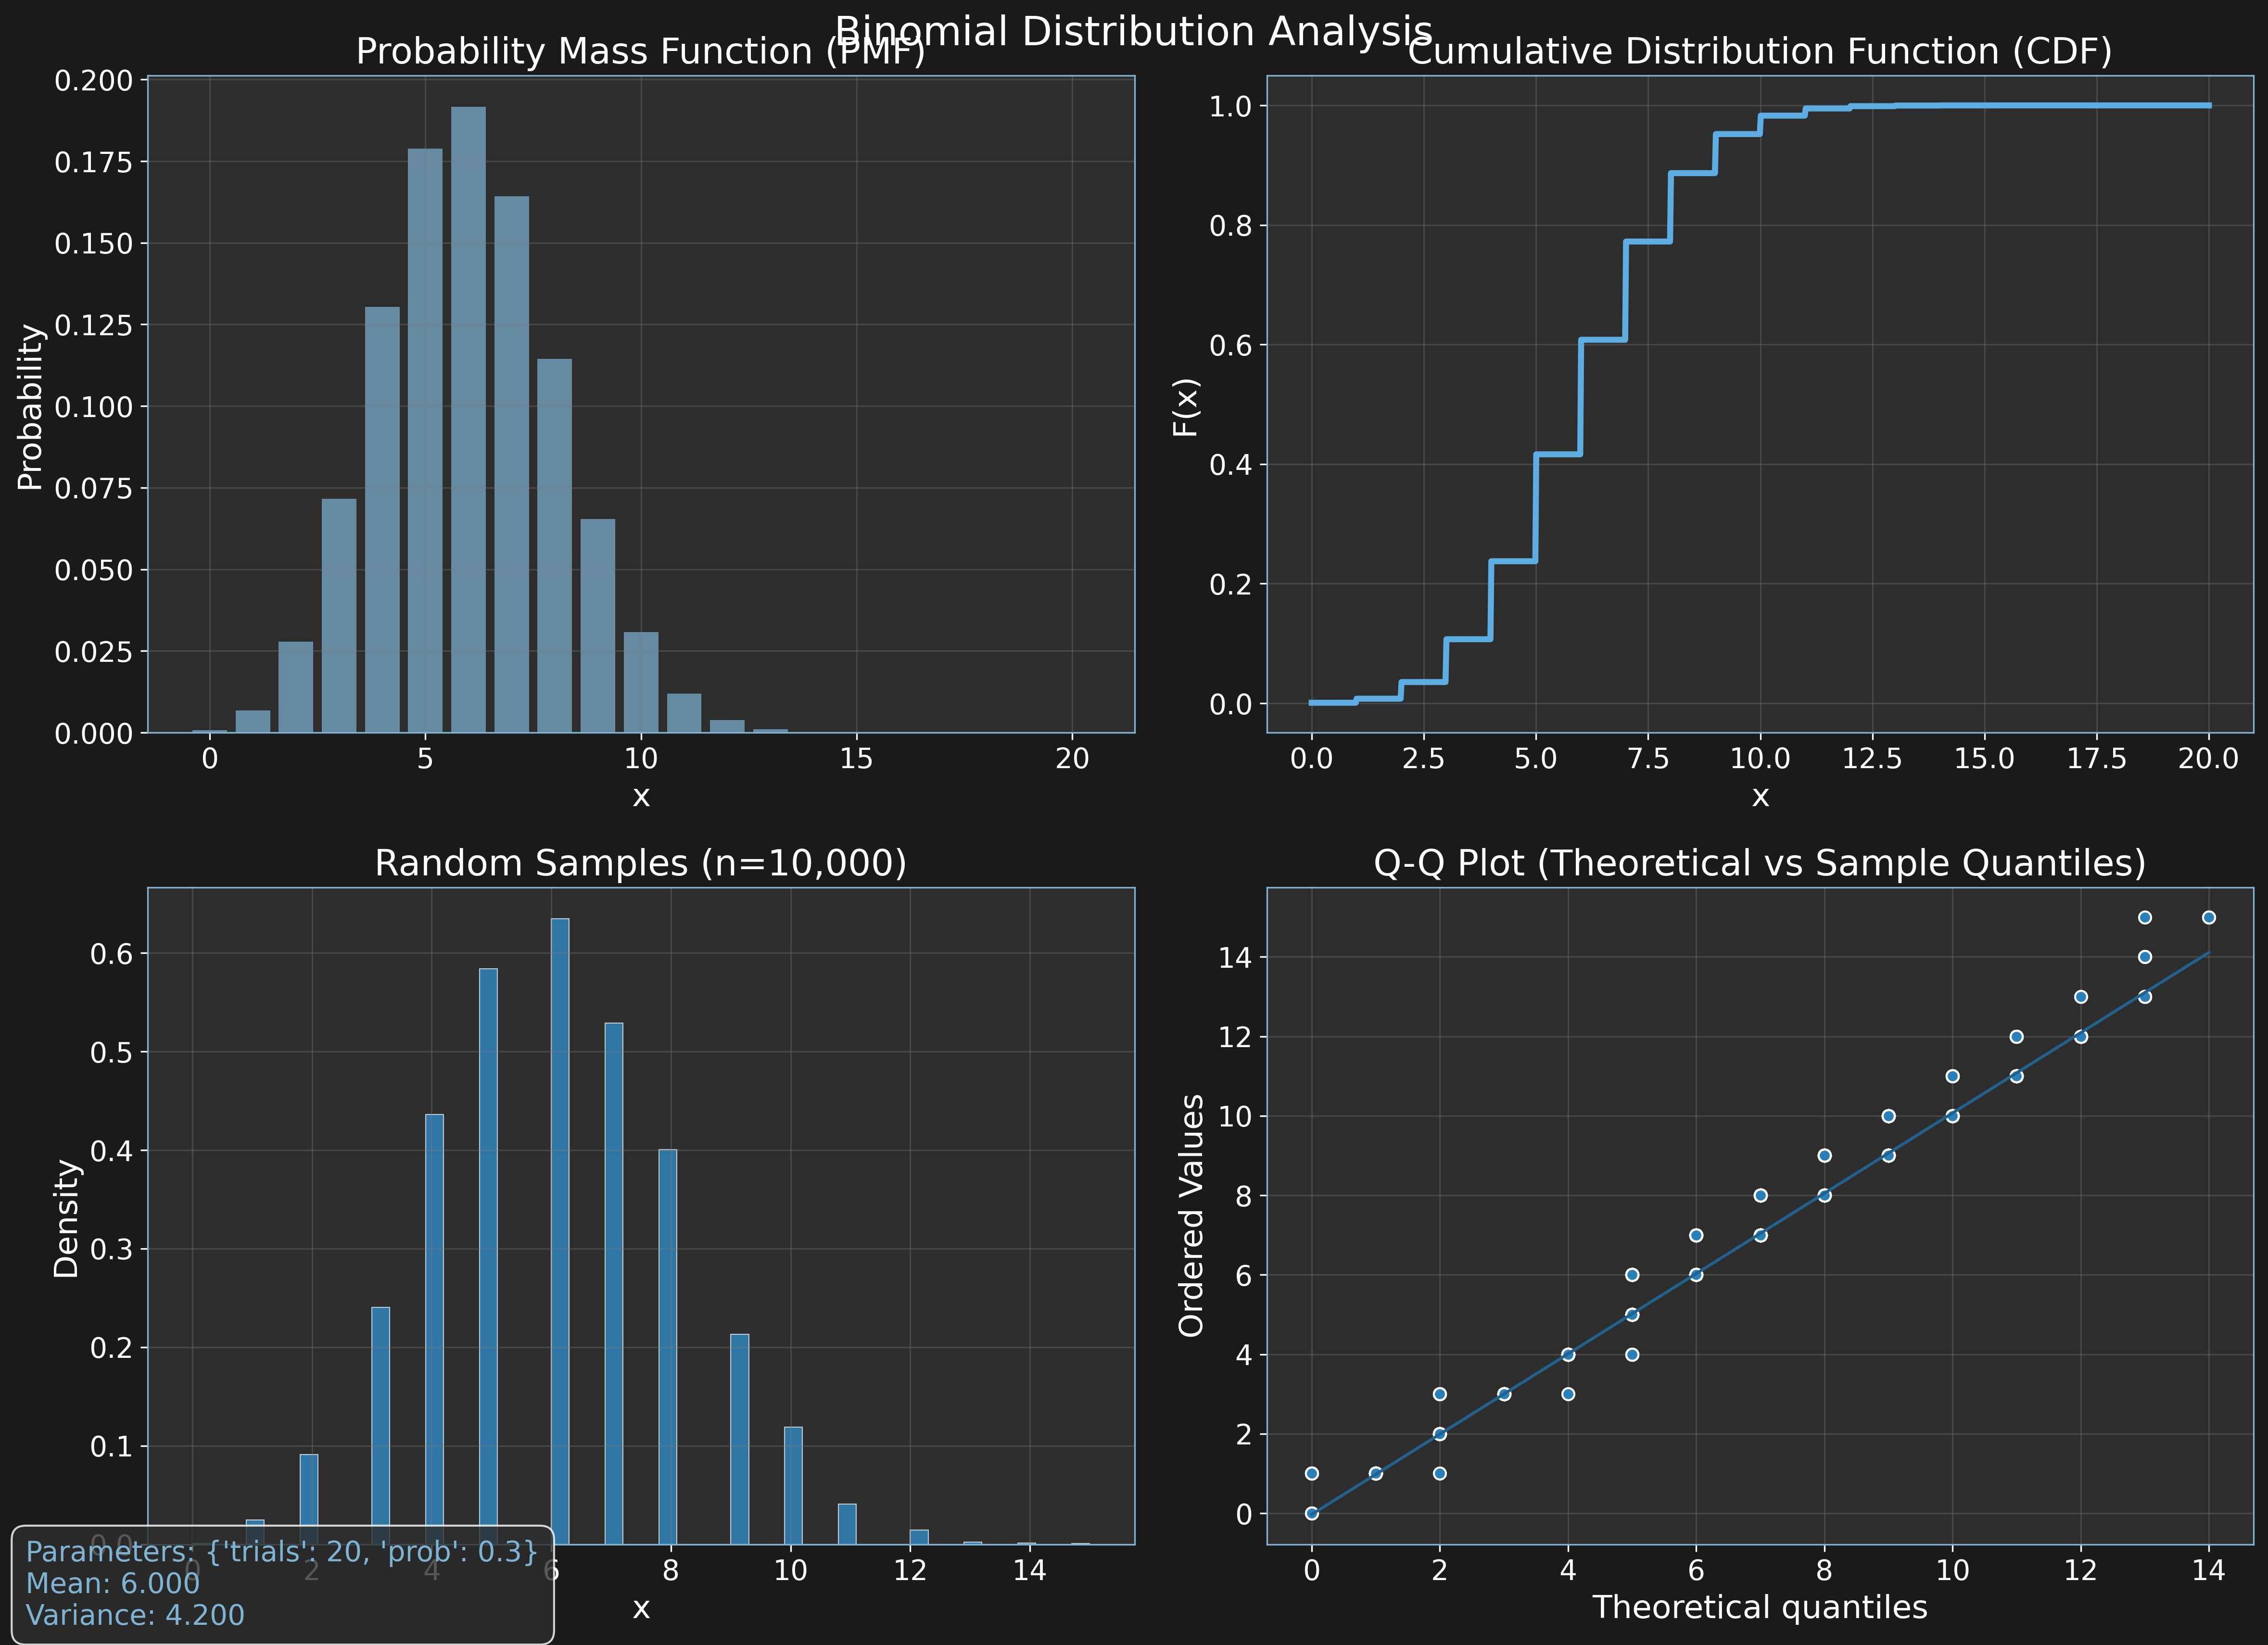
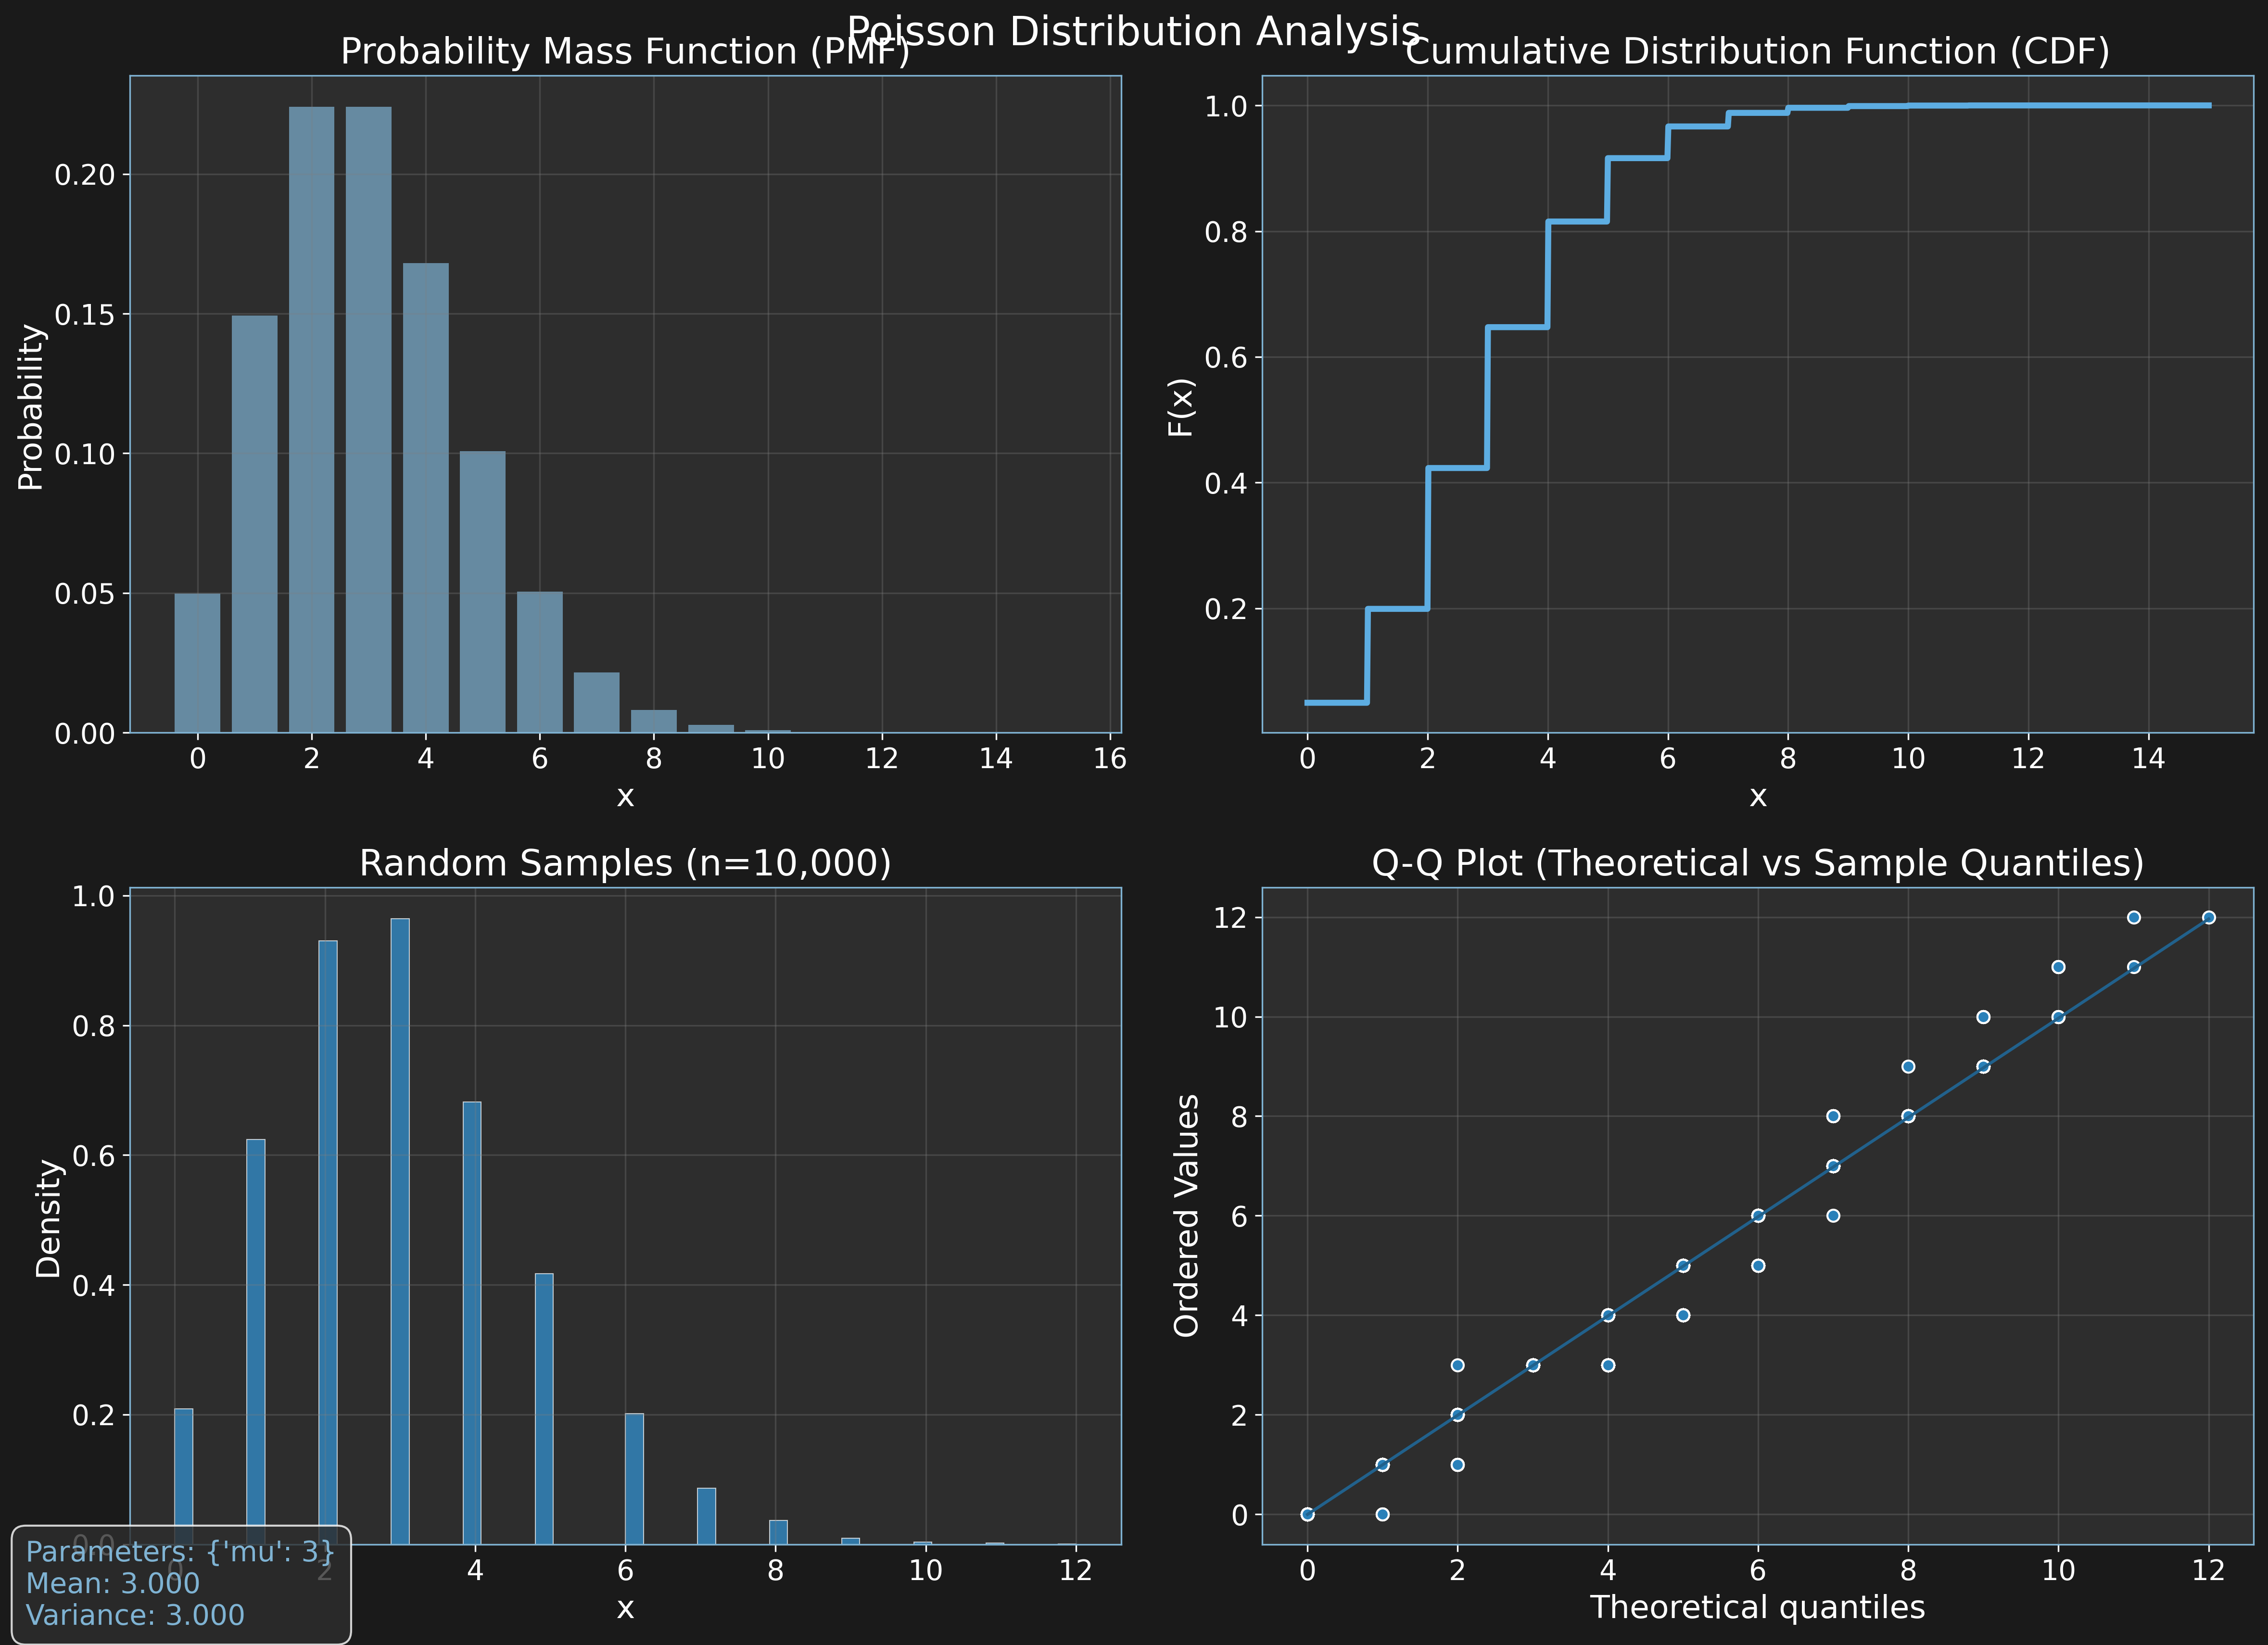
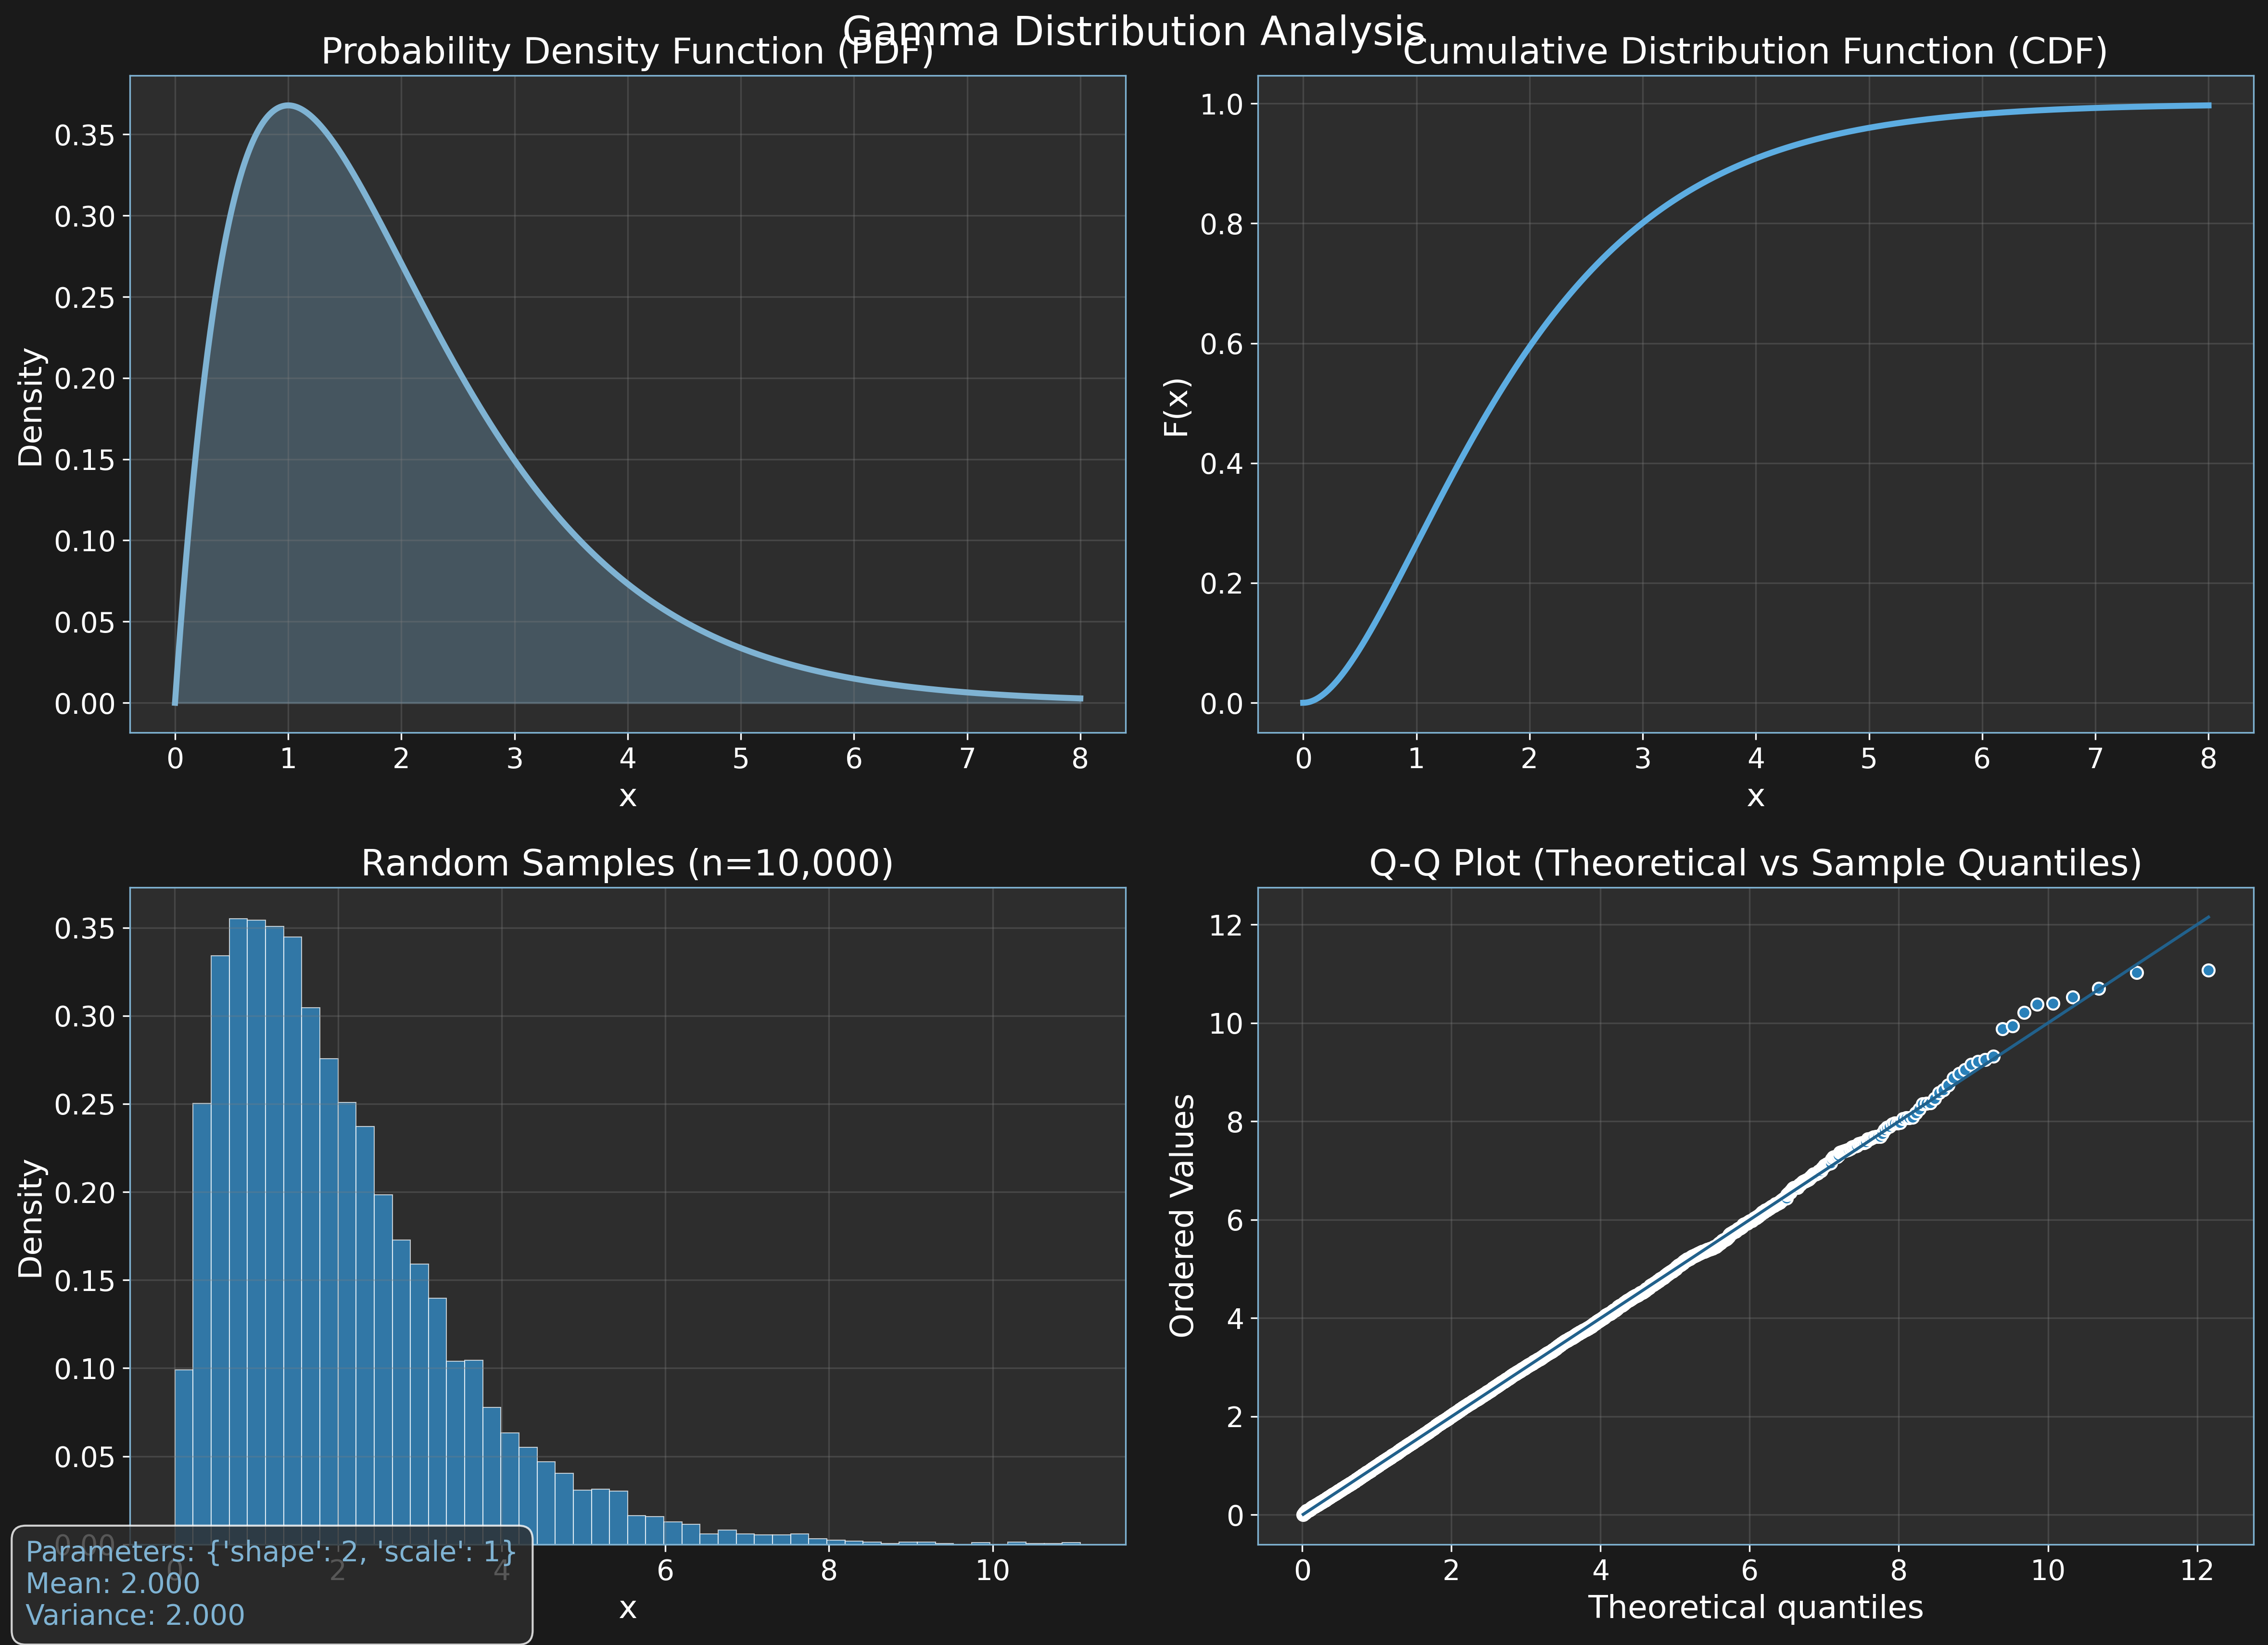
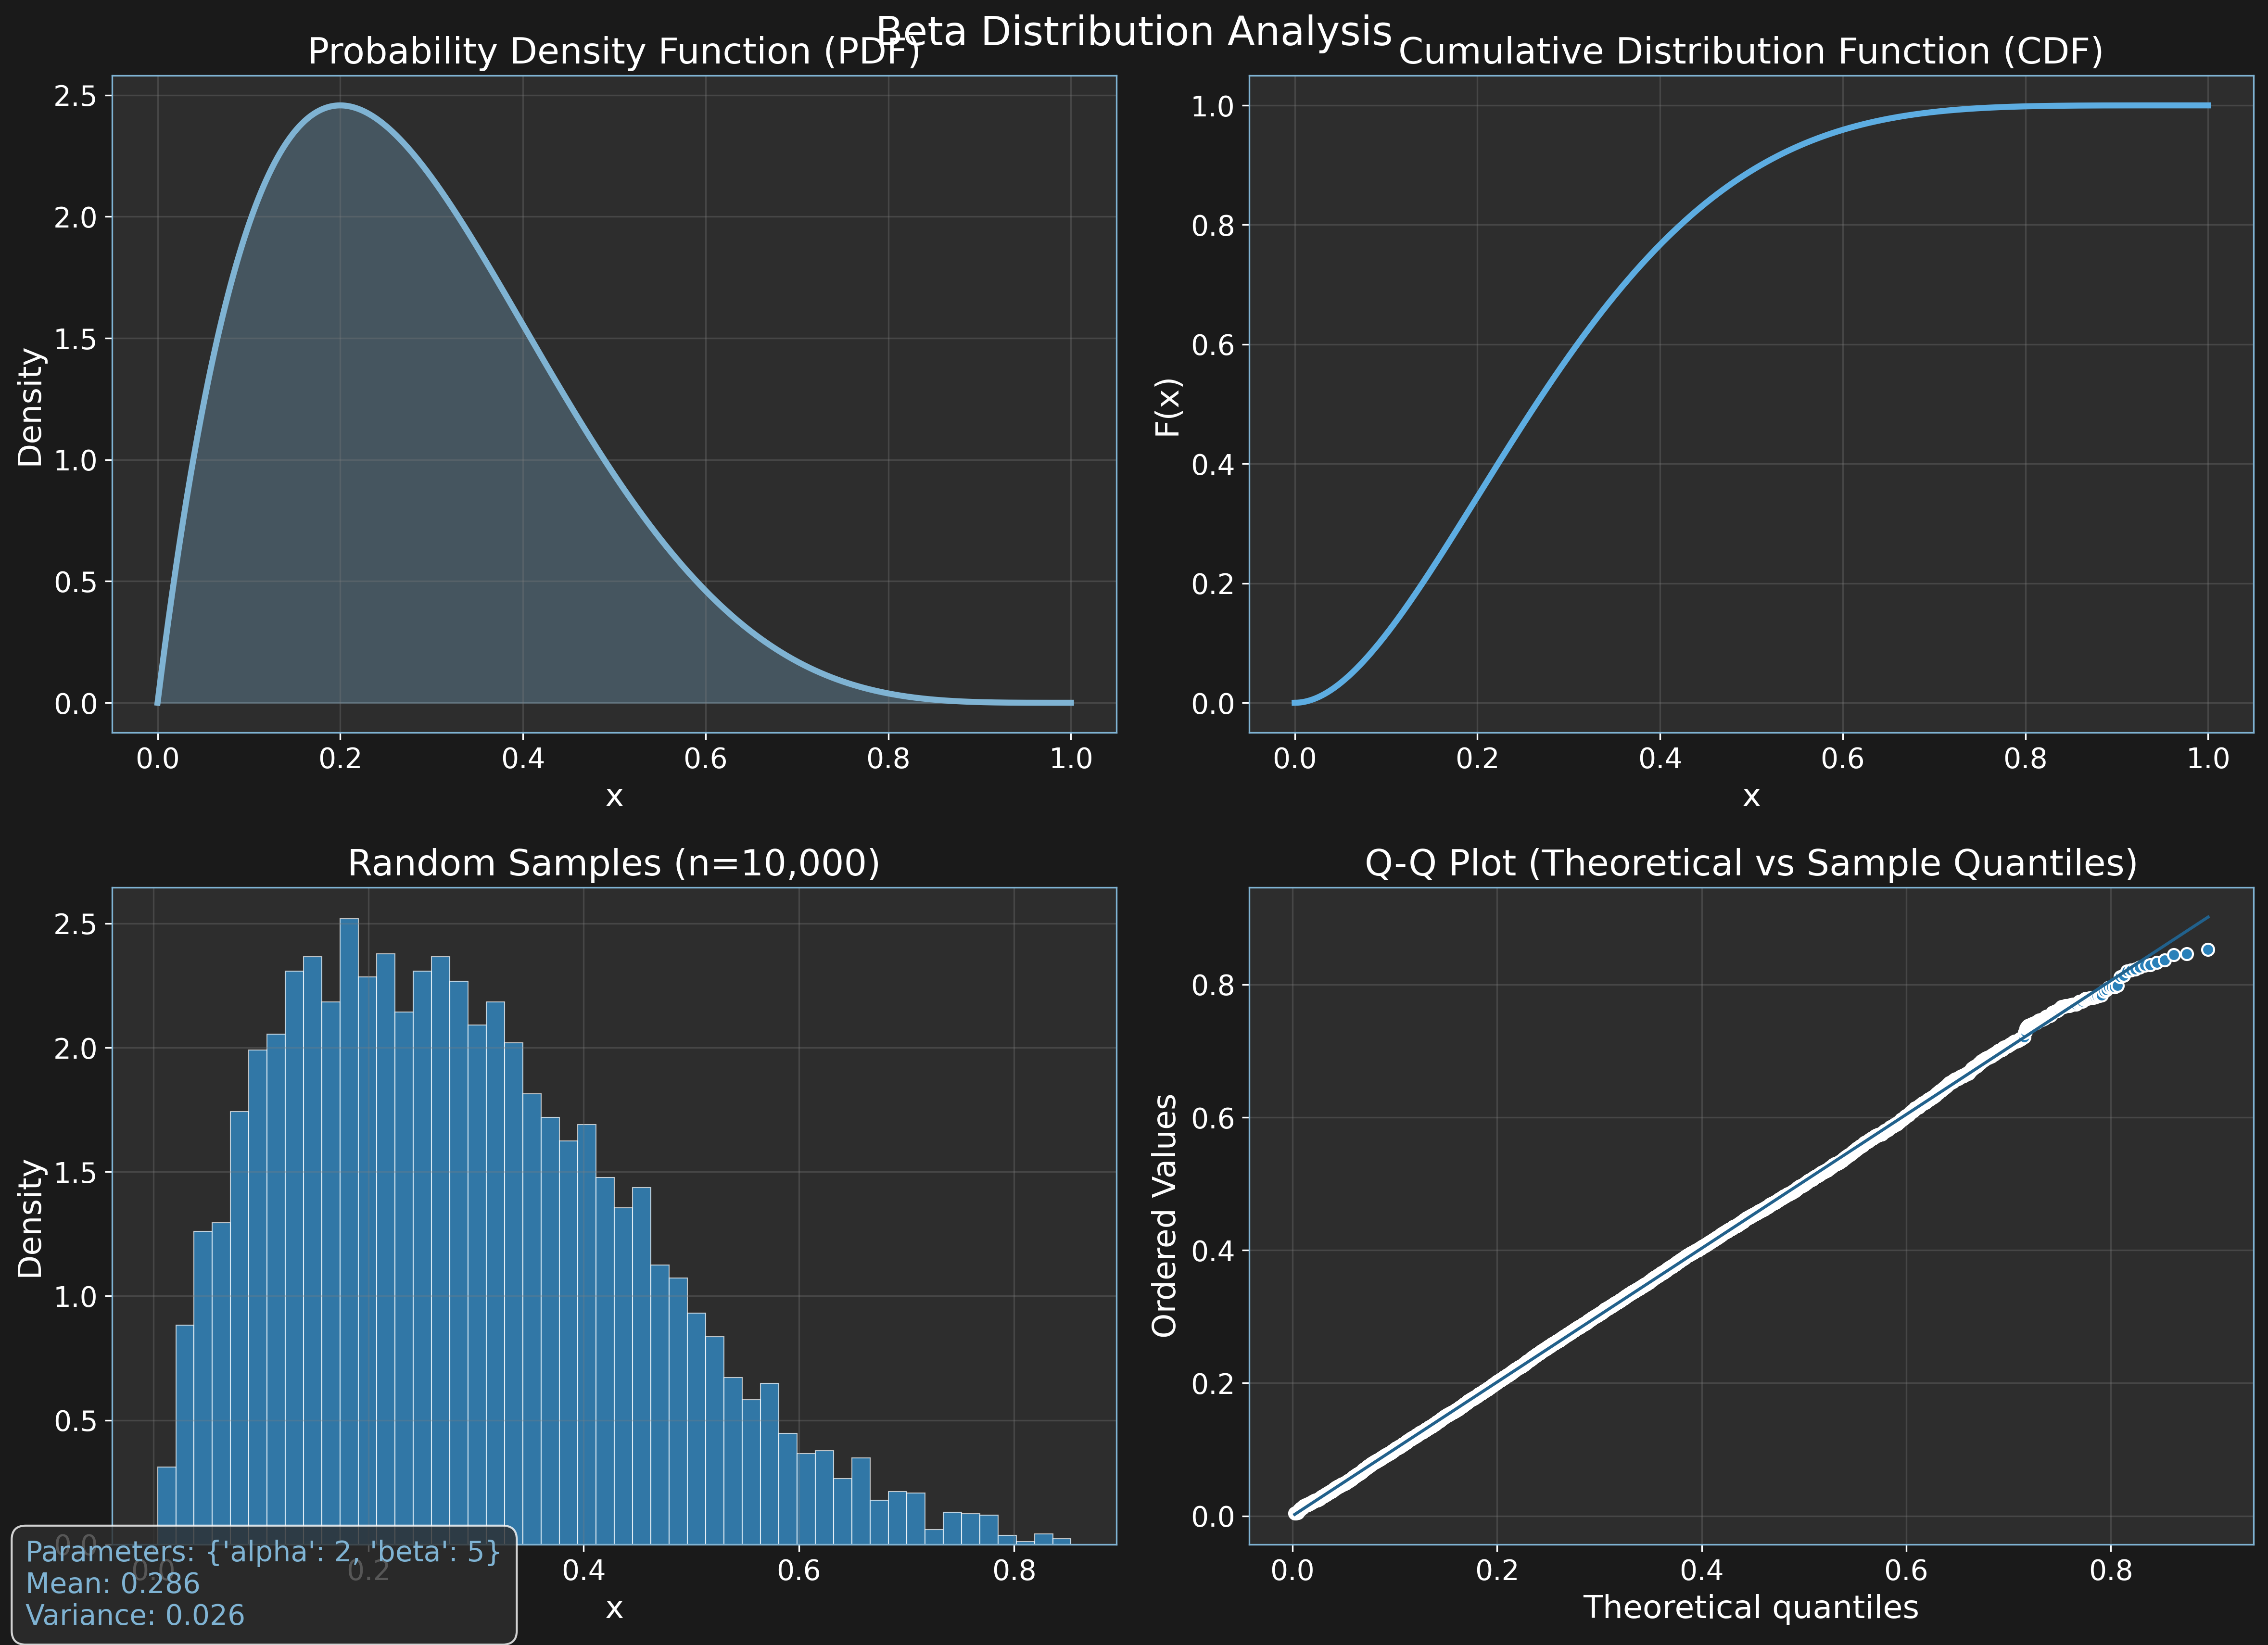
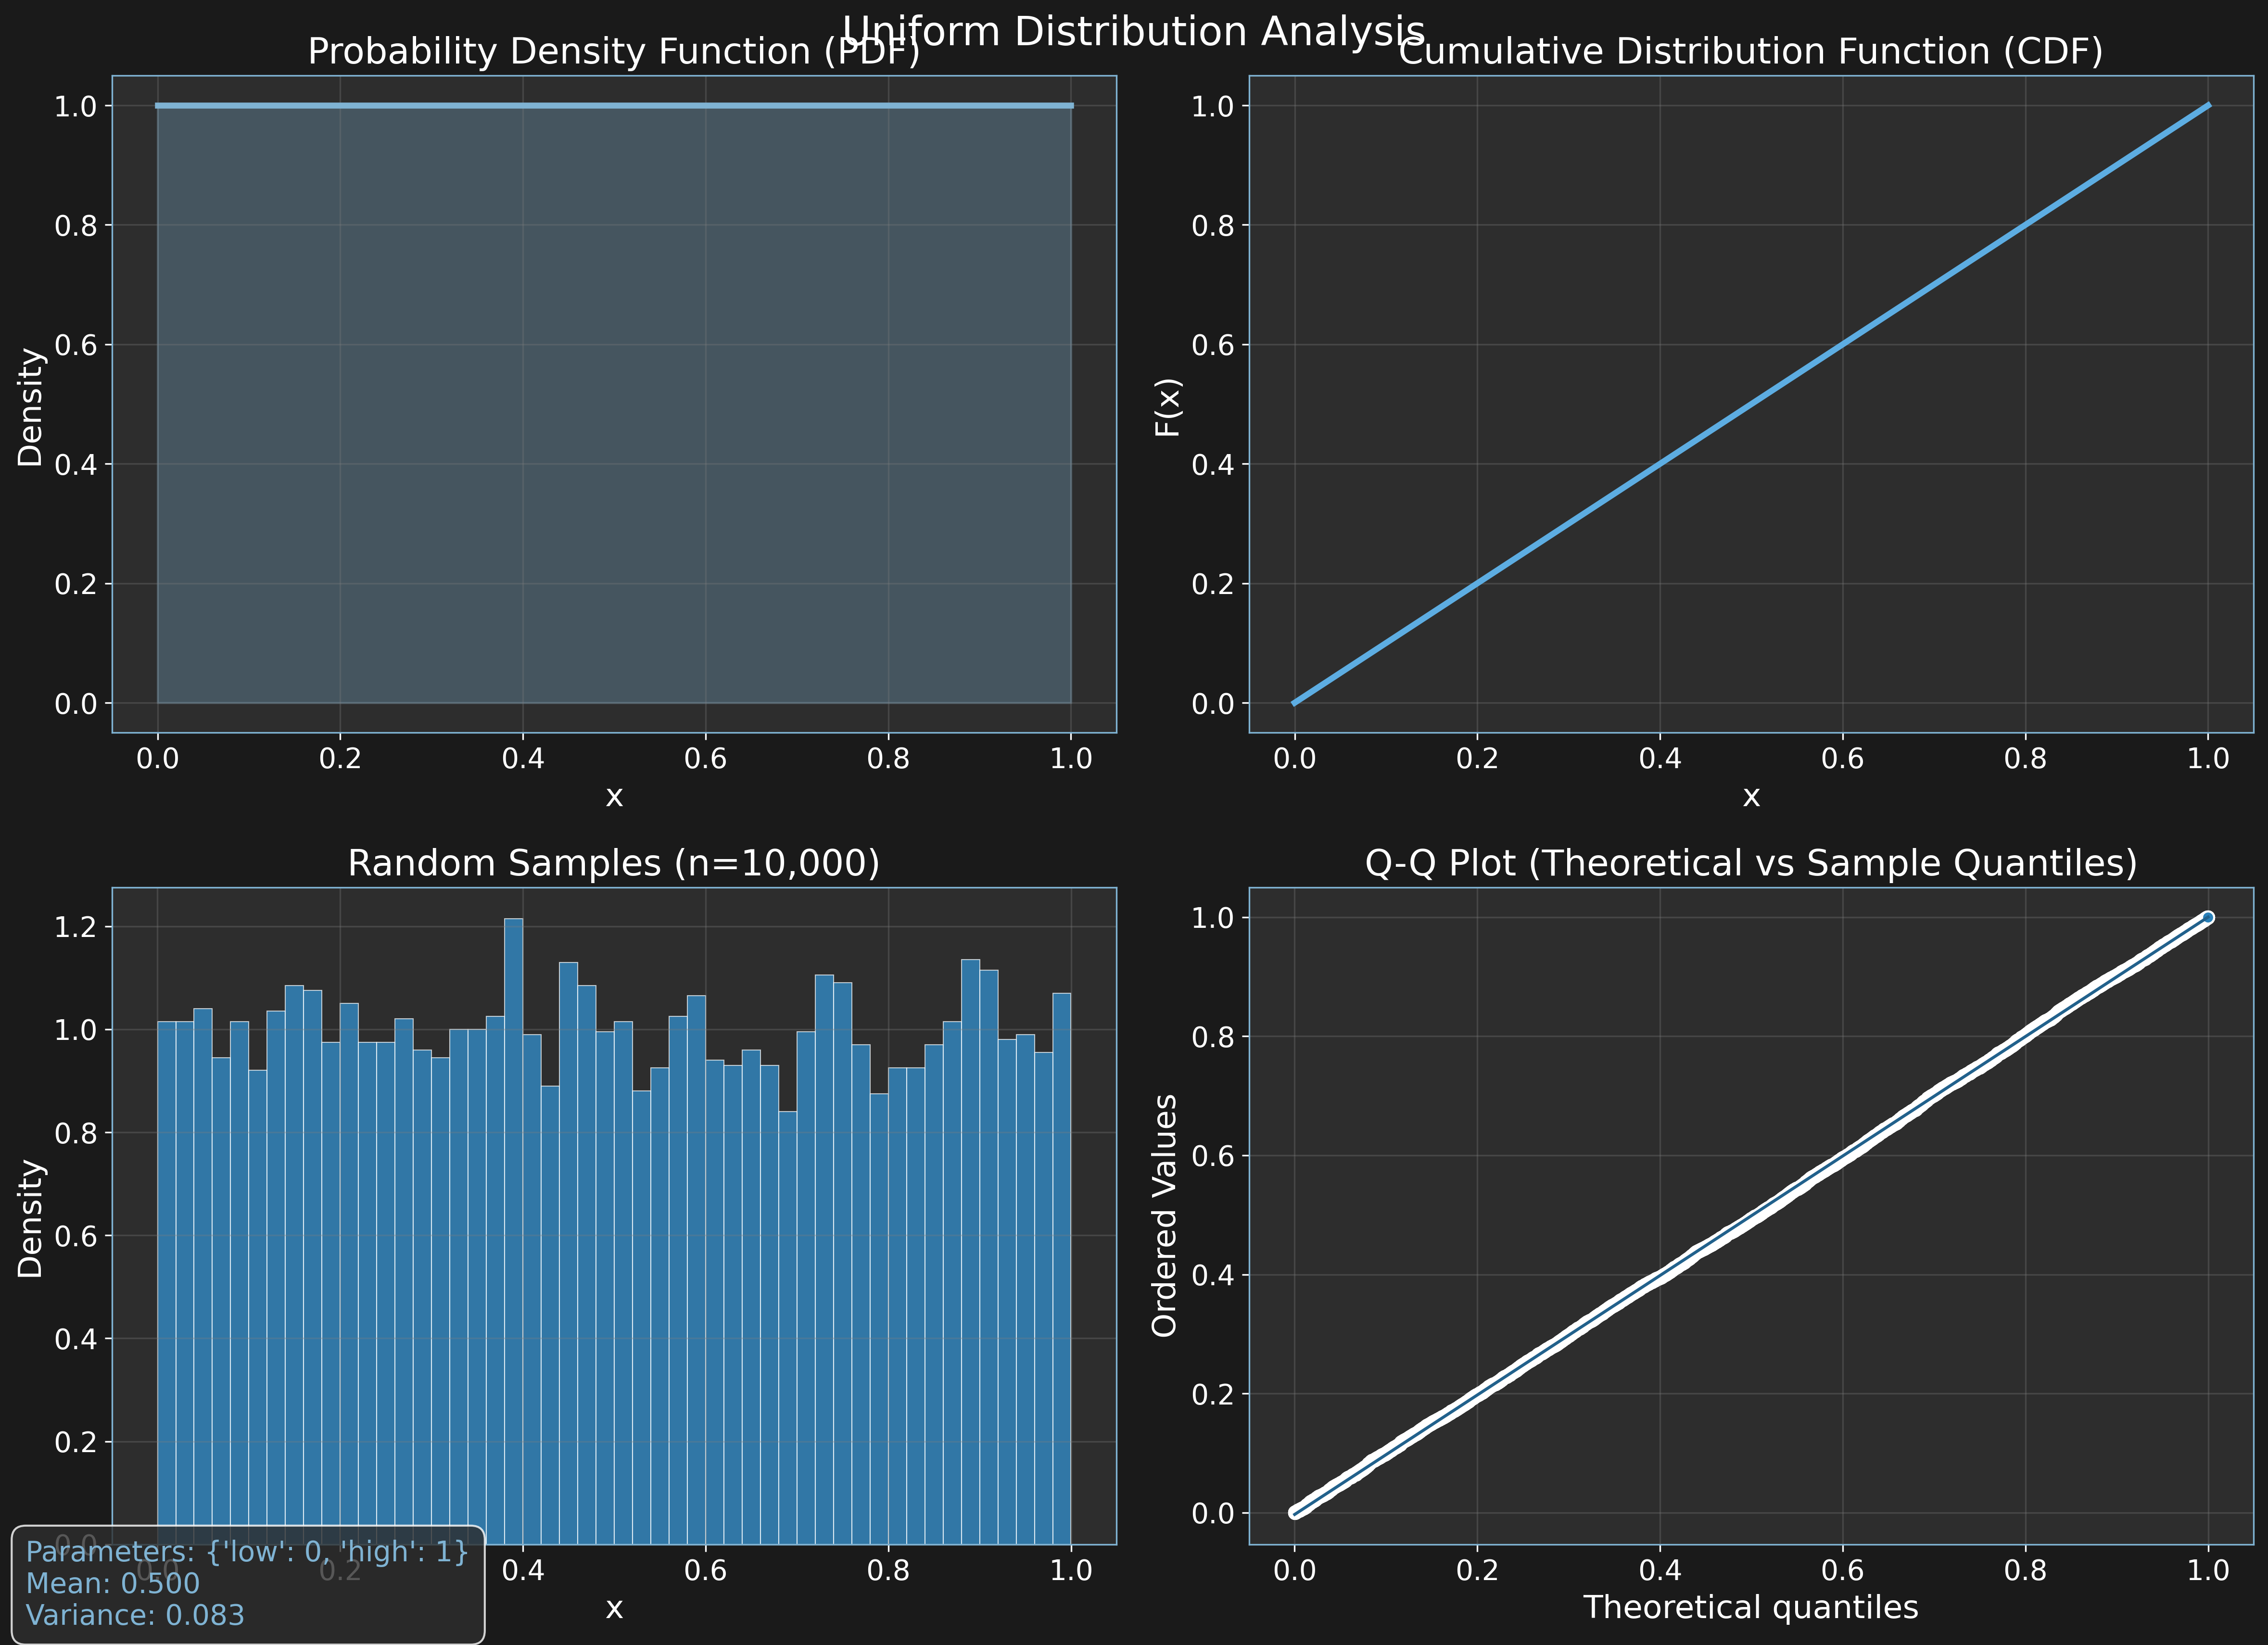
Explore fundamental probability distributions with their probability density functions (PDF), cumulative distribution functions (CDF), and random sampling implementations. Each distribution is analyzed through theoretical properties and empirical validation.
Random Sampling Methods
Implementation of random number generation for each distribution using NumPy. These methods demonstrate how to generate samples that follow specific probability distributions for simulation and analysis.
Interactive Normal Distribution
Adjust parameters to see how the distribution shape and sampling equation change in real-time:
Live Distribution Plot
Sampling Code
np.random.normal(0.0, 1.0, size=n)
Sampling Equations for All Distributions
Markov Chain Analysis
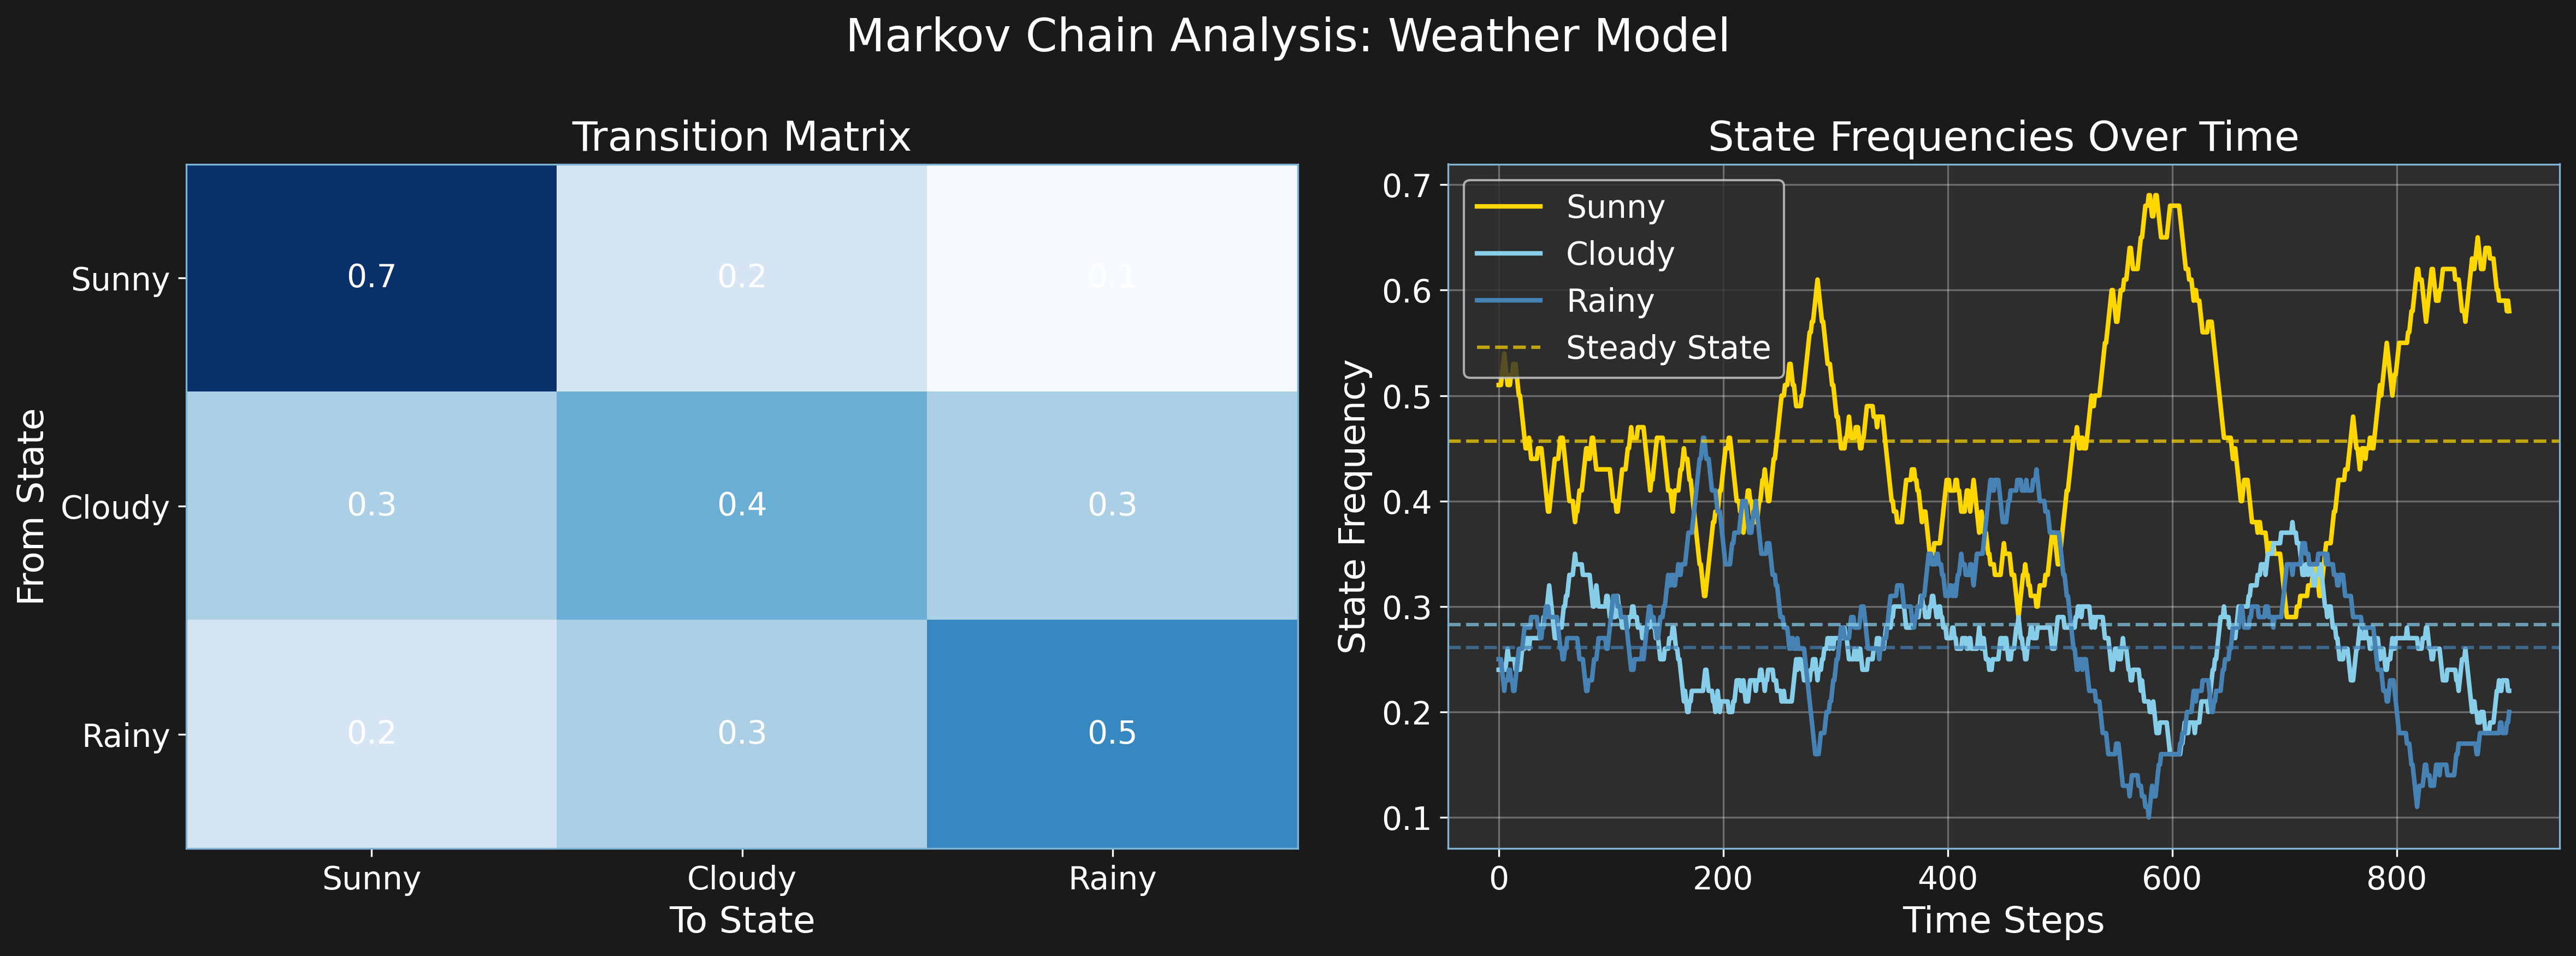
Demonstration of Markov chain modeling using a weather prediction system. The analysis shows transition probabilities, state evolution over time, and convergence to steady-state distributions. This example illustrates the memoryless property where future states depend only on the current state.
Key Concepts Demonstrated
- Transition matrix construction and interpretation
- State frequency evolution over time
- Steady-state probability calculation using eigenvalue decomposition
- Convergence behavior and equilibrium analysis
# Markov Chain Implementation
transition_matrix = np.array([
    [0.7, 0.2, 0.1],  # From Sunny
    [0.3, 0.4, 0.3],  # From Cloudy
    [0.2, 0.3, 0.5]   # From Rainy
])

# Calculate steady state
eigenvals, eigenvecs = np.linalg.eig(transition_matrix.T)
steady_state = np.real(eigenvecs[:, 0] / eigenvecs[:, 0].sum())
Maximum Likelihood Estimation
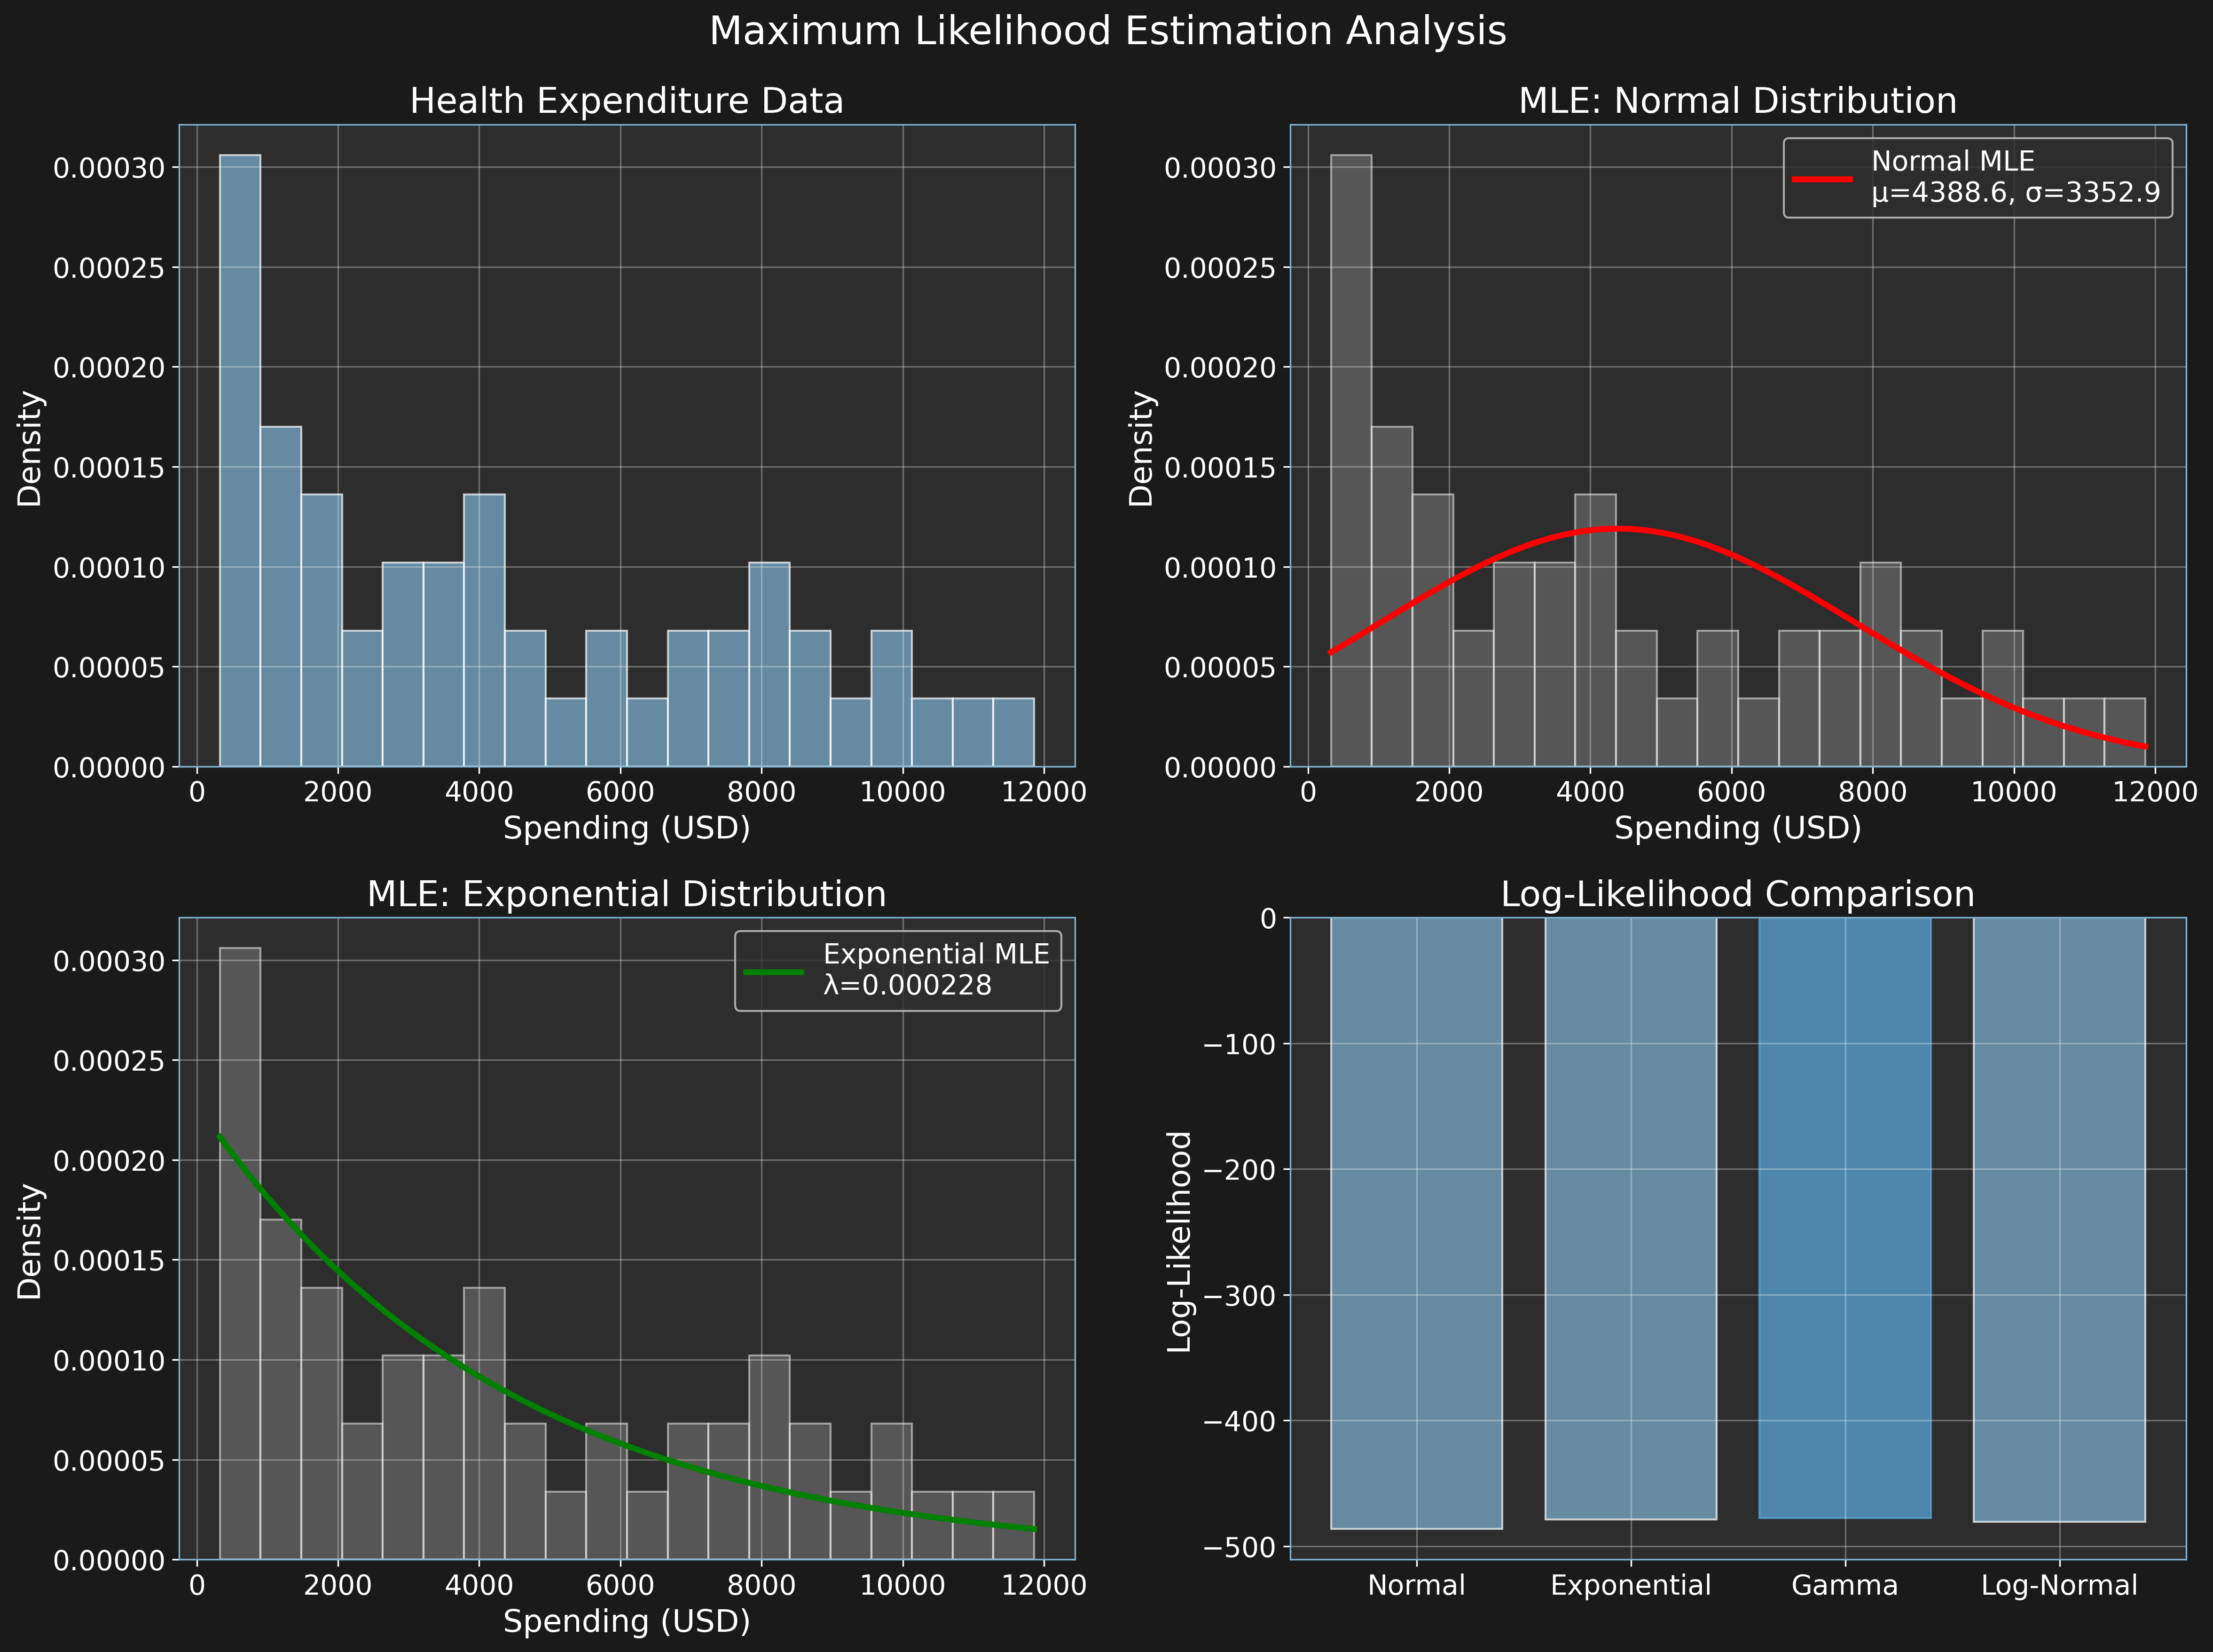
Analysis of maximum likelihood estimation using health expenditure data. The study compares different distributional assumptions and evaluates model fit through log-likelihood comparisons. This demonstrates parameter estimation methodology and model selection criteria.
Statistical Methods Applied
- Parameter estimation for multiple distribution families
- Log-likelihood calculation and comparison
- Model selection based on goodness of fit
- Visual assessment of distributional assumptions
# Maximum Likelihood Estimation
from scipy import stats

# Normal distribution MLE
mu_mle, sigma_mle = stats.norm.fit(data)
log_likelihood = np.sum(stats.norm.logpdf(data, mu_mle, sigma_mle))

# Compare multiple distributions
distributions = [stats.norm, stats.expon, stats.gamma, stats.lognorm]
best_fit = max(distributions, key=lambda d: np.sum(d.fit(data)))
Confidence Intervals
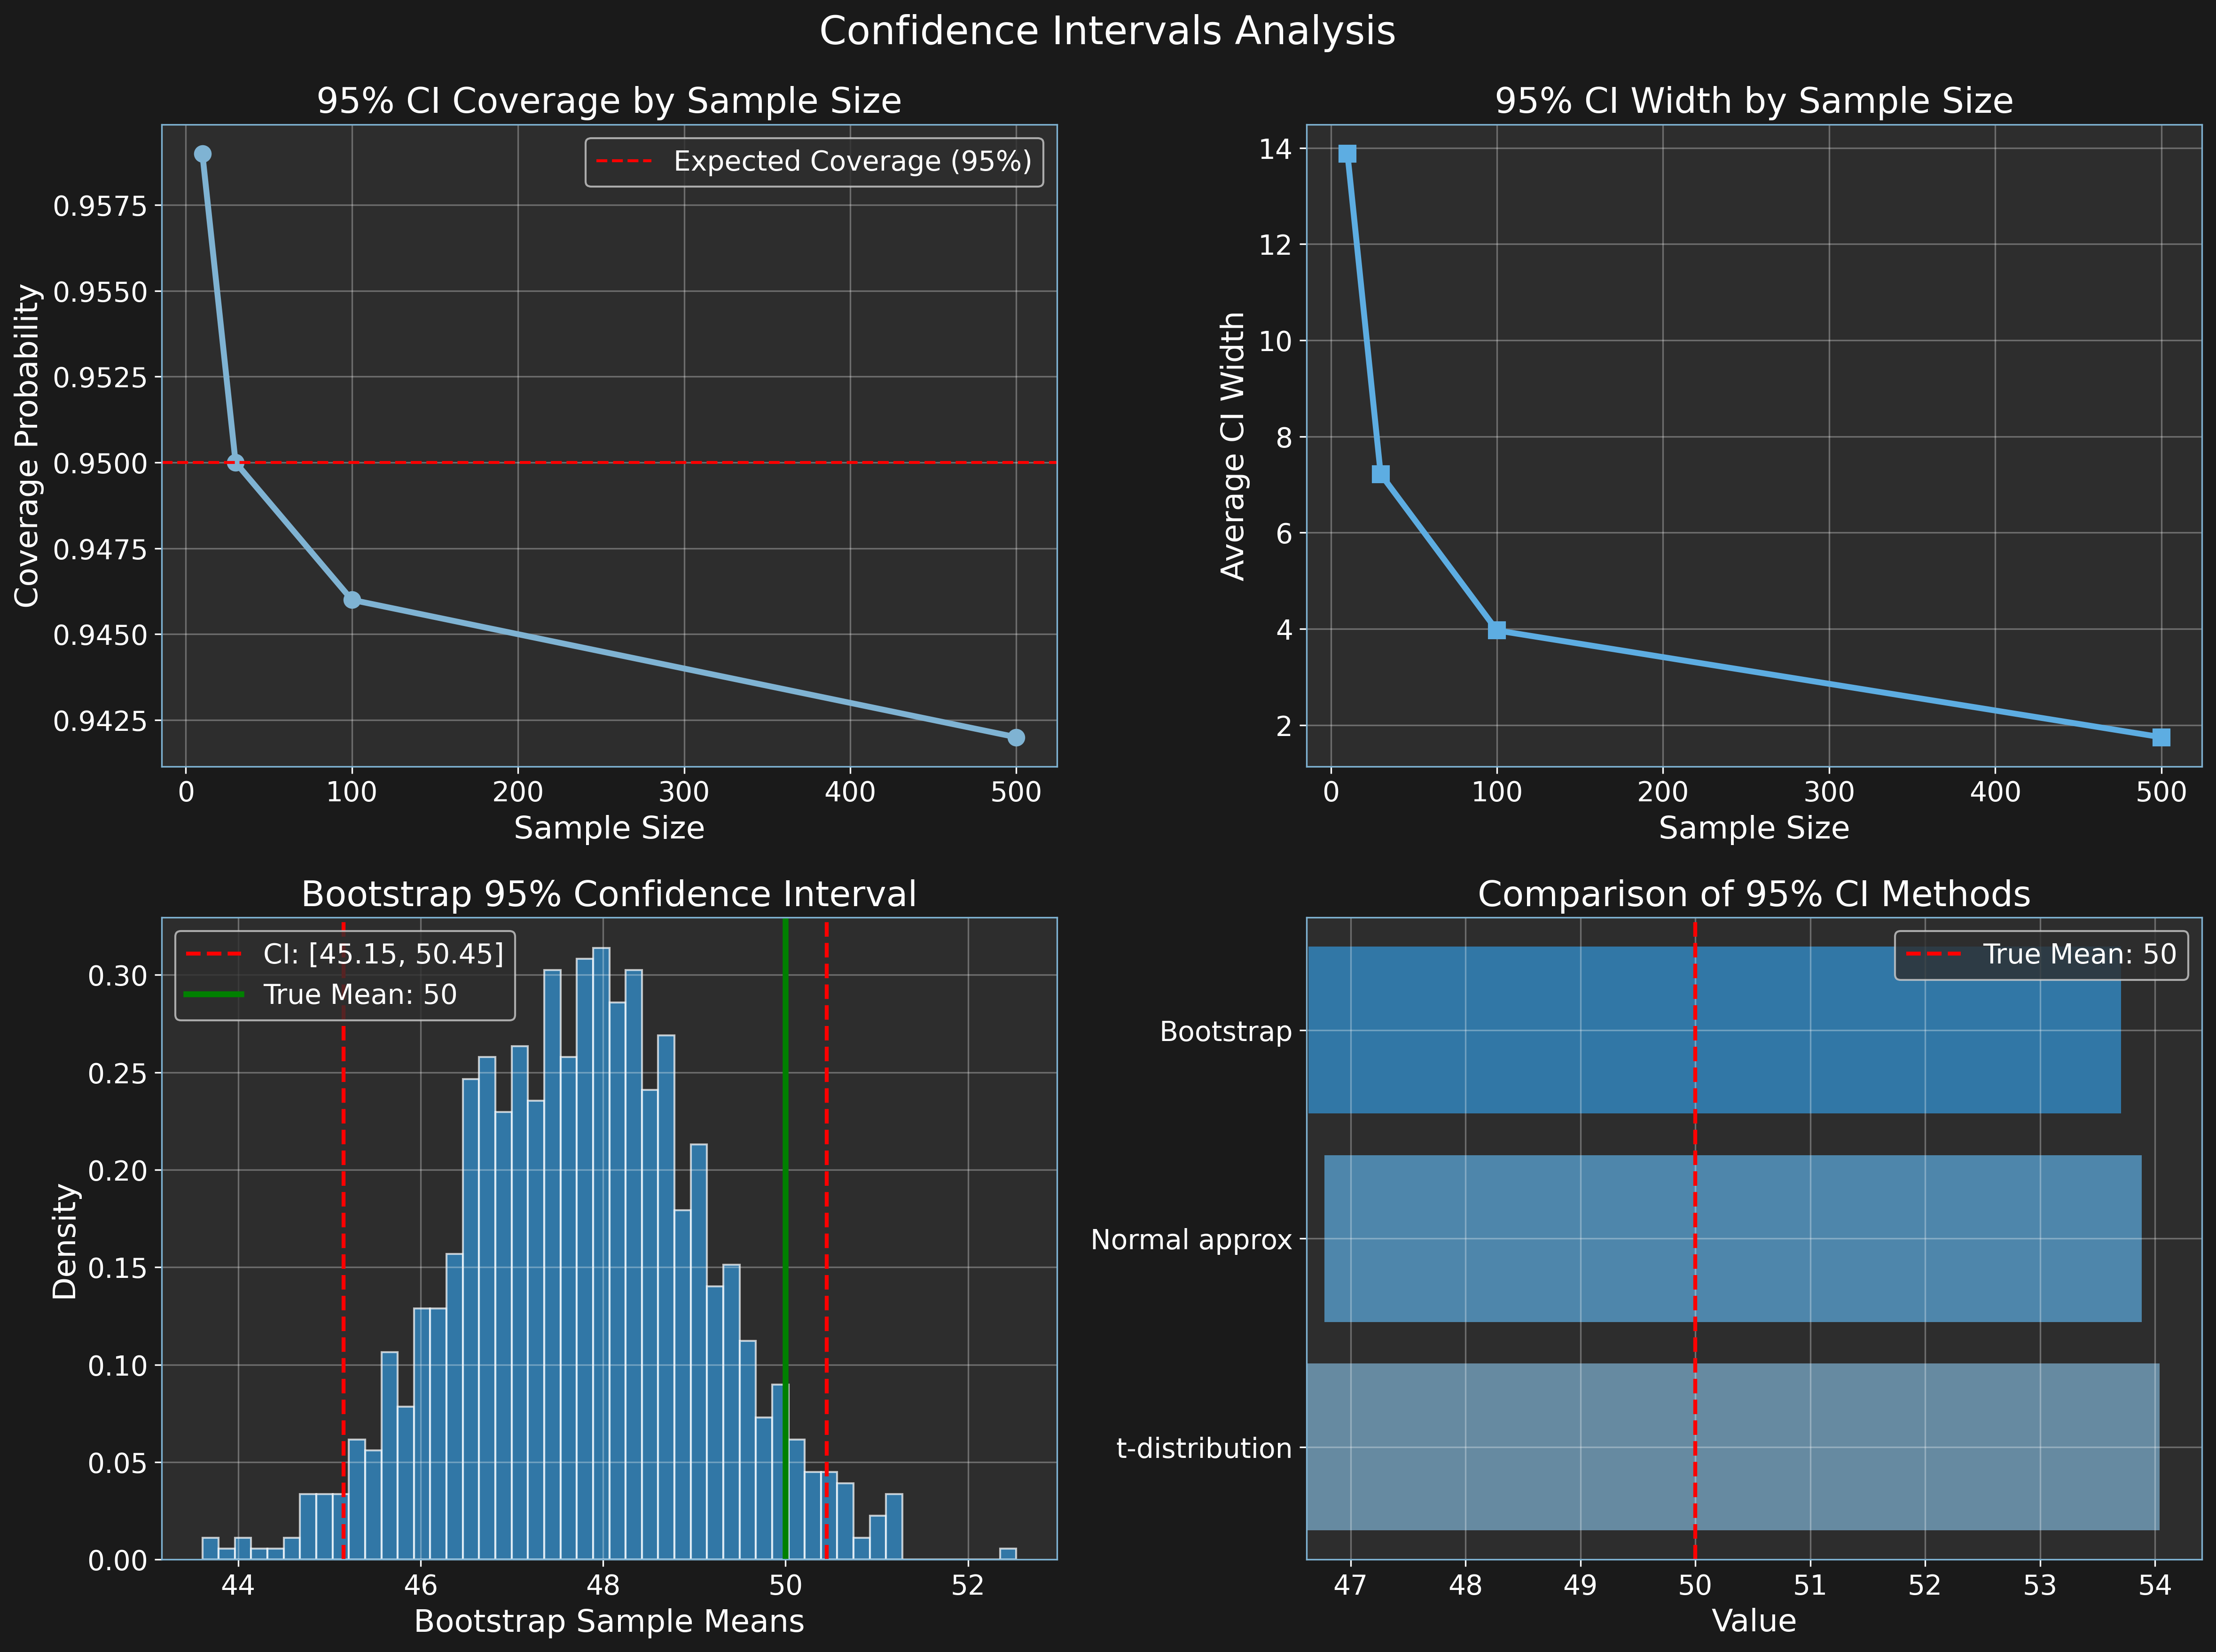
Comprehensive analysis of confidence interval construction and interpretation. The study examines coverage probabilities, interval width behavior, and comparison of different methodological approaches including parametric, non-parametric, and bootstrap methods.
Methods and Concepts
- Coverage probability validation across sample sizes
- Interval width relationship to sample size and confidence level
- Bootstrap confidence intervals using percentile method
- Comparison of t-distribution, normal approximation, and bootstrap approaches
# Confidence Interval Construction
from scipy import stats

# t-distribution CI
n = len(sample)
mean_est = np.mean(sample)
se = stats.sem(sample)
ci_t = stats.t.interval(0.95, n-1, mean_est, se)

# Bootstrap CI
bootstrap_means = [np.mean(np.random.choice(sample, size=n, replace=True))
                   for _ in range(1000)]
ci_bootstrap = (np.percentile(bootstrap_means, 2.5),
                np.percentile(bootstrap_means, 97.5))
Technical Implementation
This dashboard demonstrates proficiency in statistical computing using Python's scientific stack. The analysis pipeline combines theoretical knowledge with practical implementation skills essential for data science and statistical analysis roles.
Technologies and Libraries
# Installation and Setup
pip install -r requirements.txt
python generate_plots.py

# Core analysis pipeline
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats
import pandas as pd